Overfitting چیست؟ وقتی مدل بهجای یادگرفتن، حفظ میکند
overfitting (بیشبرازش) یعنی مدل بهجای یادگرفتنِ الگوی کلی، جزئیات و نویزِ دادهٔ آموزش را حفظ کرده است. نشانهاش این است که روی دادهٔ آموزش عالی عمل میکند و روی دادهٔ جدید بد. مثلِ دانشآموزی که جوابِ سؤالهای نمونه را از بر کرده و با تغییرِ یک عدد در امتحان گیر میکند.
یادگیری ماشین برای این است که مدل از دادههای دیدهشده الگویی بگیرد و روی دادههای ندیده به کار ببرد. overfitting دقیقاً همان جایی است که این کار شکست میخورد، و بدترین بخشش این است که تا وقتی فقط به دادهٔ آموزش نگاه میکنی، همهچیز عالی به نظر میرسد.
یک مثال با پنج نقطه
پنج داده داریم. در این مثالِ ساختگی، الگوی واقعی y = 2x است و کمی نویز به آن اضافه شده:
x |
1 |
2 |
3 |
4 |
5 |
|---|---|---|---|---|---|
y |
2.2 |
3.8 |
6.3 |
7.9 |
10.1 |
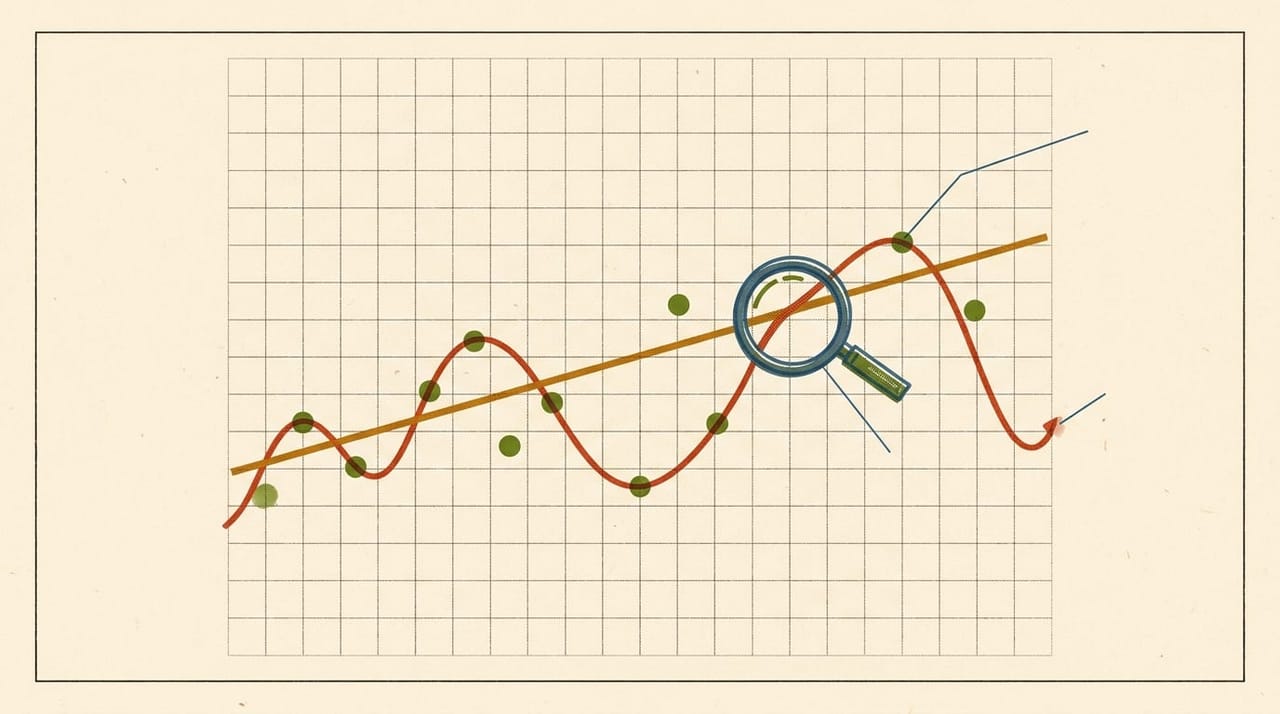
دو مدل میسازیم. اولی یک خطِ راست است. دومی یک چندجملهایِ درجه ۴، که با پنج پارامتر دقیقاً از هر پنج نقطه میگذرد:
| خط راست | چندجملهای درجه ۴ | |
|---|---|---|
| تعداد پارامتر | ۲ | ۵ |
| خطای میانگین مربعات روی دادهٔ آموزش | حدودِ 0.03 |
0 |
پیشبینی برای x = 6 |
حدودِ 12.0 |
17.7 |
اگر فقط به سطرِ خطا نگاه کنی، مدلِ درجه ۴ کامل است. ولی برای x = 6 جوابی میدهد که از مقدارِ واقعی، یعنی 12، خیلی دور است. خطِ ساده با خطای غیرصفر، الگو را گرفته و مدلِ پیچیده با خطای صفر، نویز را.
میتوانی این عددها را خودت تکرار کنی:
import numpy as np

x = np.array([1, 2, 3, 4, 5])
y = np.array([2.2, 3.8, 6.3, 7.9, 10.1])

for degree in (1, 4):
    c = np.polyfit(x, y, degree)
    train_error = np.mean((np.polyval(c, x) - y) ** 2)
    print(degree, round(train_error, 4), round(np.polyval(c, 6), 2))
خطای صفر روی دادهٔ آموزش دستاورد نیست. ممکن است نشانهٔ حفظکردن باشد.
چرا مدل نویز را حفظ میکند
مدل نمیداند کدام بخشِ داده الگوست و کدام نویز. تنها چیزی که میبیند این است که باید خطا را کم کند. اگر آنقدر انعطاف داشته باشد که بتواند از هر نقطه بگذرد، و دادهٔ کافی جلویش را نگیرد، خطا را با حفظکردن کم میکند.
عوامل اصلی اینها هستند:
- مدلِ زیادی انعطافپذیر نسبت به مسئله. مثل چندجملهایِ درجه ۴ برای پنج نقطه.
- دادهٔ کم. با دادهٔ بیشتر، حفظکردنِ همهٔ نویز سختتر میشود و الگوی مشترک غالب میشود.
- دادهٔ پرنویز. هرچه نویز بیشتر باشد، چیزِ غلطِ بیشتری برای حفظکردن هست.
- آموزشِ بیش از حد. در شبکههای عصبی، مدل با ادامهٔ آموزش معمولاً اول الگوهای کلی را میگیرد و بعد سراغِ جزئیات میرود.
overfitting و underfitting
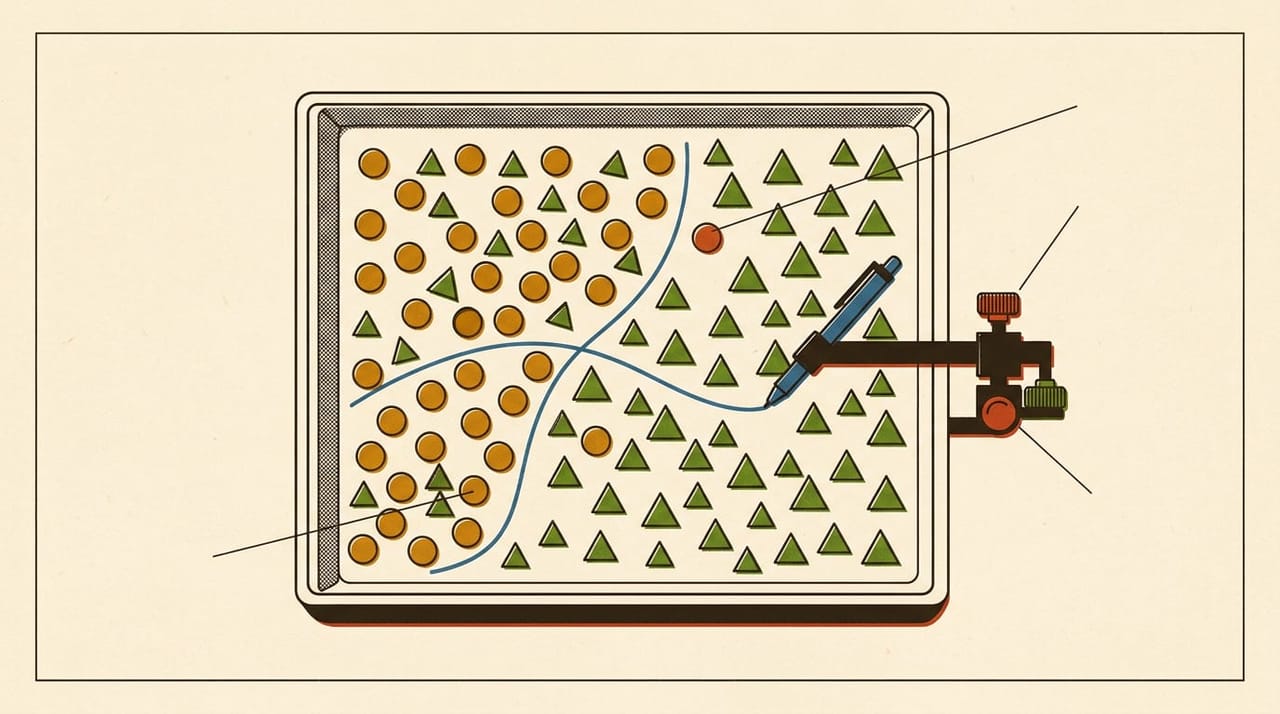
طرفِ دیگرِ این طیف هم وجود دارد: underfitting، یعنی مدل آنقدر ساده است که حتی الگوی اصلی را هم نمیگیرد.
underfitting |
مناسب | overfitting |
|
|---|---|---|---|
| خطا روی دادهٔ آموزش | زیاد | کم | خیلی کم |
| خطا روی دادهٔ جدید | زیاد | کم | زیاد |
| شبیه | کسی که درس نخوانده | کسی که فهمیده | کسی که فقط حفظ کرده |
مثالش در همان داده: مدلی که برای همه y = 6 را پیشبینی کند. نه روی آموزش خوب است نه روی آزمون.
چطور overfitting را تشخیص بدهیم
تنها راهِ مطمئن، سنجیدنِ مدل روی دادهای است که هرگز ندیده. پس داده را از اول جدا میکنیم:
train: مدل با این یاد میگیرد.validation: با این تصمیم میگیری چه مدلی و چه تنظیماتی بهتر است.test: فقط در پایان، برای گزارشِ عددِ نهایی.
نشانهٔ اصلی فاصله است. جدولِ زیر عددهای فرضیاند و فقط شکلِ رایجِ منحنیها را نشان میدهند:
| دورهٔ آموزش | خطای train |
خطای validation |
برداشت |
|---|---|---|---|
| ابتدا | 0.90 |
0.92 |
هر دو زیاد، هنوز یاد نگرفته |
| میانه | 0.30 |
0.34 |
هر دو کم، وضع خوب |
| آخر | 0.05 |
0.55 |
فاصلهٔ زیاد، حفظکردن |
وقتی خطای train کم میشود و خطای validation دیگر کم نمیشود یا بالا میرود، مدل از یادگرفتن به حفظکردن رسیده است.
اگر داده کم است، cross-validation کمک میکند: داده را به چند قسمت تقسیم میکنی و هر بار با یکی از قسمتها میسنجی. اینطور نتیجه به یک تقسیمِ شانسی وابسته نمیماند.
راههای جلوگیری
| روش | چه میکند |
|---|---|
| دادهٔ بیشتر | بهترین راه اگر ممکن باشد؛ حفظکردن سختتر میشود |
| مدل سادهتر | پارامترِ کمتر، جای کمتر برای حفظکردن |
regularization |
برای وزنهای بزرگ جریمه میگذارد و مدل را سادهتر نگه میدارد |
dropout |
در آموزش، بخشی از نورونها را تصادفی خاموش میکند تا شبکه به یک مسیر تکیه نکند |
early stopping |
آموزش را وقتی خطای validation بهتر نمیشود متوقف میکند |
data augmentation |
از هر داده نسخههای تازه میسازد، مثلاً تصویرِ چرخاندهشده |
ترتیبِ معقول معمولاً این است: اول یک مدلِ ساده بهعنوانِ خطِ پایه، بعد پیچیدهترکردن تا جایی که کمک کند، و بعد کنترلِ حفظکردن.
دامی که از overfitting بدتر است
گاهی عددِ validation هم عالی است و مدل در دنیای واقعی باز هم شکست میخورد. دو دلیلِ رایج دارد.
نشتیِ داده (data leakage). اطلاعاتی از دادههای آزمون به آموزش راه پیدا کرده. مثلاً ستونی که عملاً همان جواب است، یا نرمالسازیِ کلِ داده پیش از جداکردن. اگر نتیجه بیش از حد خوب بود، اول به این شک کن.
فرسودنِ دادهٔ آزمون. اگر بارها با test نتیجه را بسنجی و مدل را عوض کنی، خودت مدل را روی test برازش دادهای. برای همین آن را تا آخر کنار میگذاریم.
یک نکتهٔ صادقانه: پارامتر زیاد همیشه بد نیست
شاید از مثالِ بالا نتیجه بگیری که پارامترِ بیشتر همیشه یعنی overfitting. این در مدلهای کلاسیک شهودِ خوبی است، ولی کلِ داستان نیست. شبکههای بزرگ گاهی پارامترهایی بیشتر از تعدادِ داده دارند و میتوانند دادهٔ آموزش را کامل حفظ کنند، و با این حال روی دادهٔ جدید خوب کار میکنند. دلیلش هنوز موضوعِ پژوهش است.
پس قاعدهٔ درست «پارامتر کم نگه دار» نیست. قاعدهٔ درست این است: همیشه روی دادهای که مدل ندیده بسنج.
در کنارِ این، overfitting با توهم هوش مصنوعی یکی نیست. وقتی مدلِ زبانی جوابِ ساختگی میدهد، معمولاً دلیلش این است که تولید میکند، نه اینکه دادهٔ آموزش را زیاد حفظ کرده باشد. هرچند حفظکردنِ بخشهایی از متنِ آموزش هم در مدلهای زبانی یک مسئلهٔ واقعی است.
جمعبندی
overfitting یعنی فاصله بینِ عملکرد روی دادههای دیدهشده و ندیده. آن را با جداکردنِ داده میبینی و با دادهٔ بیشتر، مدلِ سادهتر یا regularization کنترل میکنی. اگر میخواهی همین را در پایتون و با scikit-learn روی دادهٔ واقعی ببینی، خودآموز سرنخ در ترمِ یادگیری ماشین یک فصل کامل برایش دارد.
اگر میخواهی این موضوع را کامل یاد بگیری

خودآموز پایتون و برنامهنویسی برای هوش مصنوعی (مقدماتی)
آموزش پایتون برای هوش مصنوعی، از اولین خط کد تا یک ابزار منتشرشده. داده را میبینی، مدل میسازی، و مهمتر از همه یاد میگیری چطور صادقانه اندازه بگیری که واقعاً کار میکند. همهچیز در Google Colab — بدون نصب، بدون سختافزار خاص.
- ۵ ترم
- ۴۹ فصل
- همهٔ فصلها رایگان