فایل آموزشی
آموزش پایتون برای هوش مصنوعی و یادگیری ماشین از صفر؛ مقدماتی (خودآموز سرنخ)
خودآموز برنامهنویسی پایتون برای هوش مصنوعی، از اولین خط کد: کار با داده، یادگیری ماشین، مدلهای ازپیشآموزشدیده و انتشار یک ابزار هوش مصنوعی واقعی، همراه با اندازهگیری صادقانهٔ اینکه مدل واقعاً کار میکند. همه در Google Colab، بدون نصب. خودآموز دانلودی کامل و مستقل با جواب تمرینها؛ قالب PDF، EPUB و MOBI، دانلود از حساب کاربری پس از پرداخت.
امتیاز خریدارهای این خودآموز
هنوز امتیازی نیست
میانگین از سومین امتیاز
- ۵ ستاره: ۰ نفر
- ۴ ستاره: ۰ نفر
- ۳ ستاره: ۰ نفر
- ۲ ستاره: ۰ نفر
- ۱ ستاره: ۰ نفر
- قیمت
- ۴۹۹٬۰۰۰ تومان
- قالب
- PDF · EPUB · MOBI
- تعداد صفحه
- ۶۸۵
- حجم
- ۲۷٫۱ مگابایت
- زبان
- فارسی
برای خرید حساب کاربری لازم است و فایل بعد از پرداخت در حساب من میماند.
هر فایل به نام خریدارش آماده میشود: شمارهٔ موبایل و شناسهٔ حساب با خطی ریز در حاشیهٔ صفحهها میآید. برای کاربرانِ زیر ۱۸ سال، بخشی از شماره پوشانده میشود.
این فایل نسخهٔ دانلودی خودآموز سرنخ — خودآموز پایتون و برنامهنویسی برای هوش مصنوعی (مقدماتی) است.
دربارهٔ این فایل
نسخهٔ دانلودی خودآموز «سرنخ — خودآموز برنامهنویسی برای هوش مصنوعی (مقدماتی)» با ۴۹ فصل و ۶۸۵ صفحه.
خودآموزی کامل و مستقل با جوابِ تمرینها: برای خواندن و تمرین به سایت نیازی نیست. فهرست کامل و چند صفحهٔ نمونه را همینجا ببین.
پیشنمایش
این تصویرها چند صفحه از همین فایلاند.
 صفحهٔ ۲
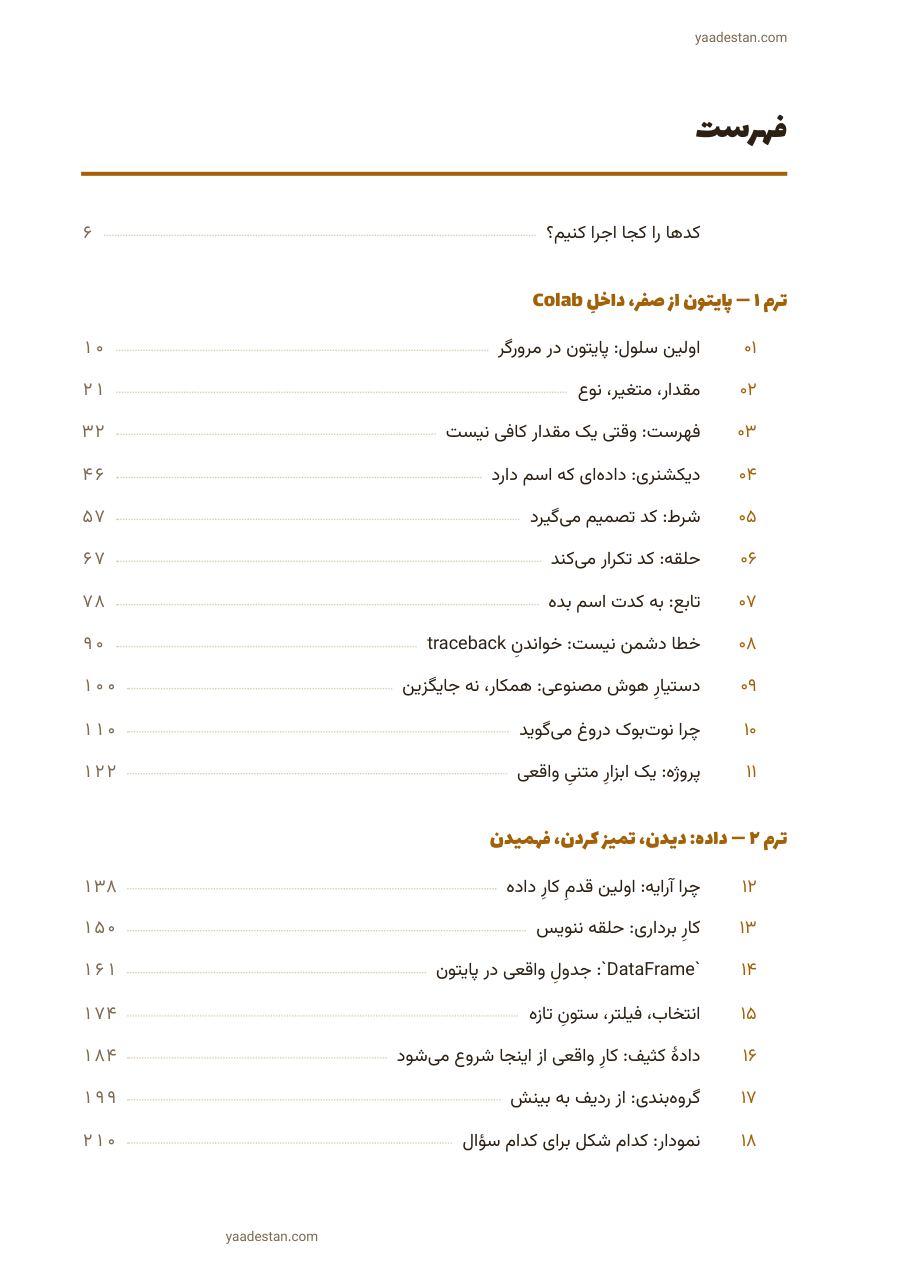 صفحهٔ ۳
 صفحهٔ ۱۰
 صفحهٔ ۱۱
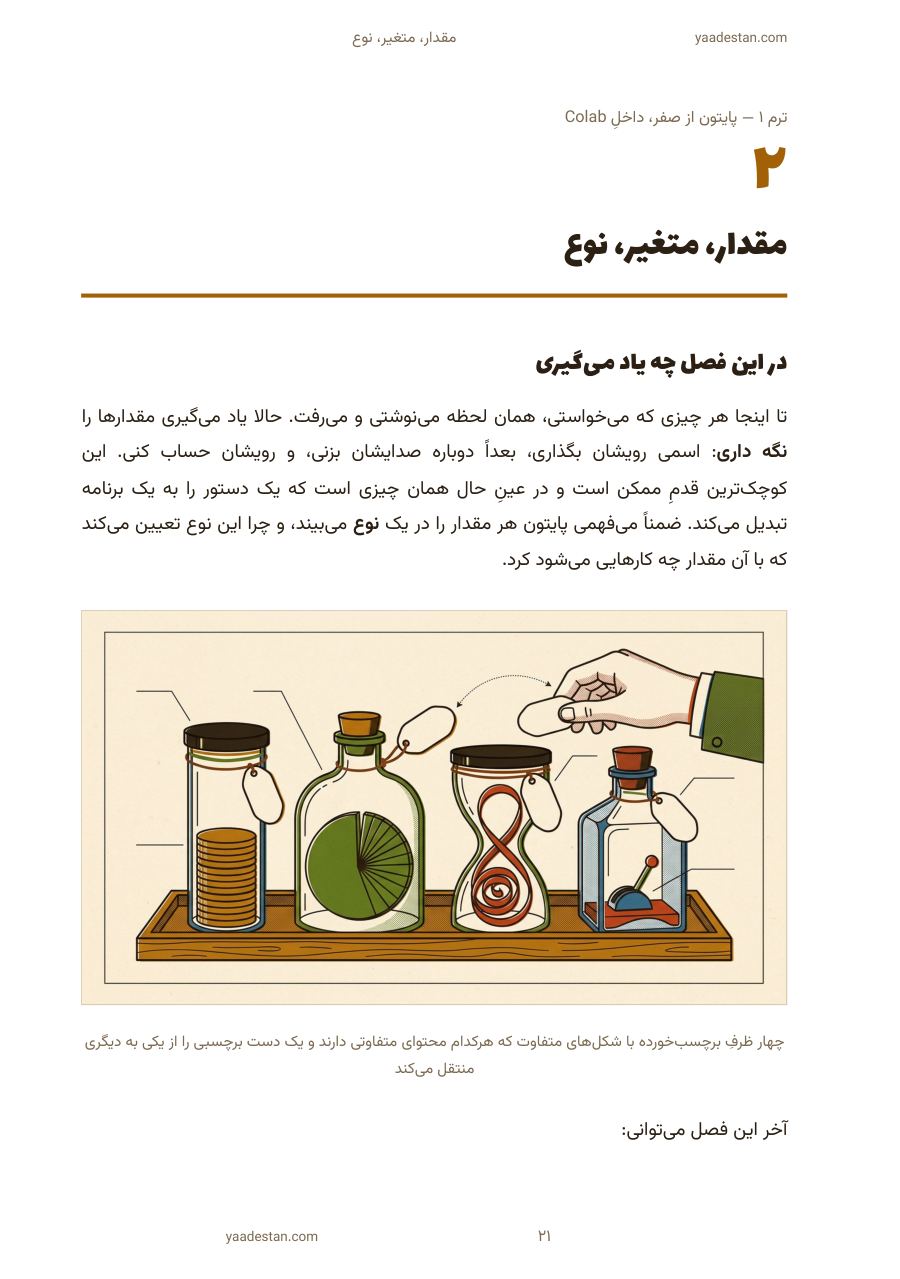 صفحهٔ ۲۱
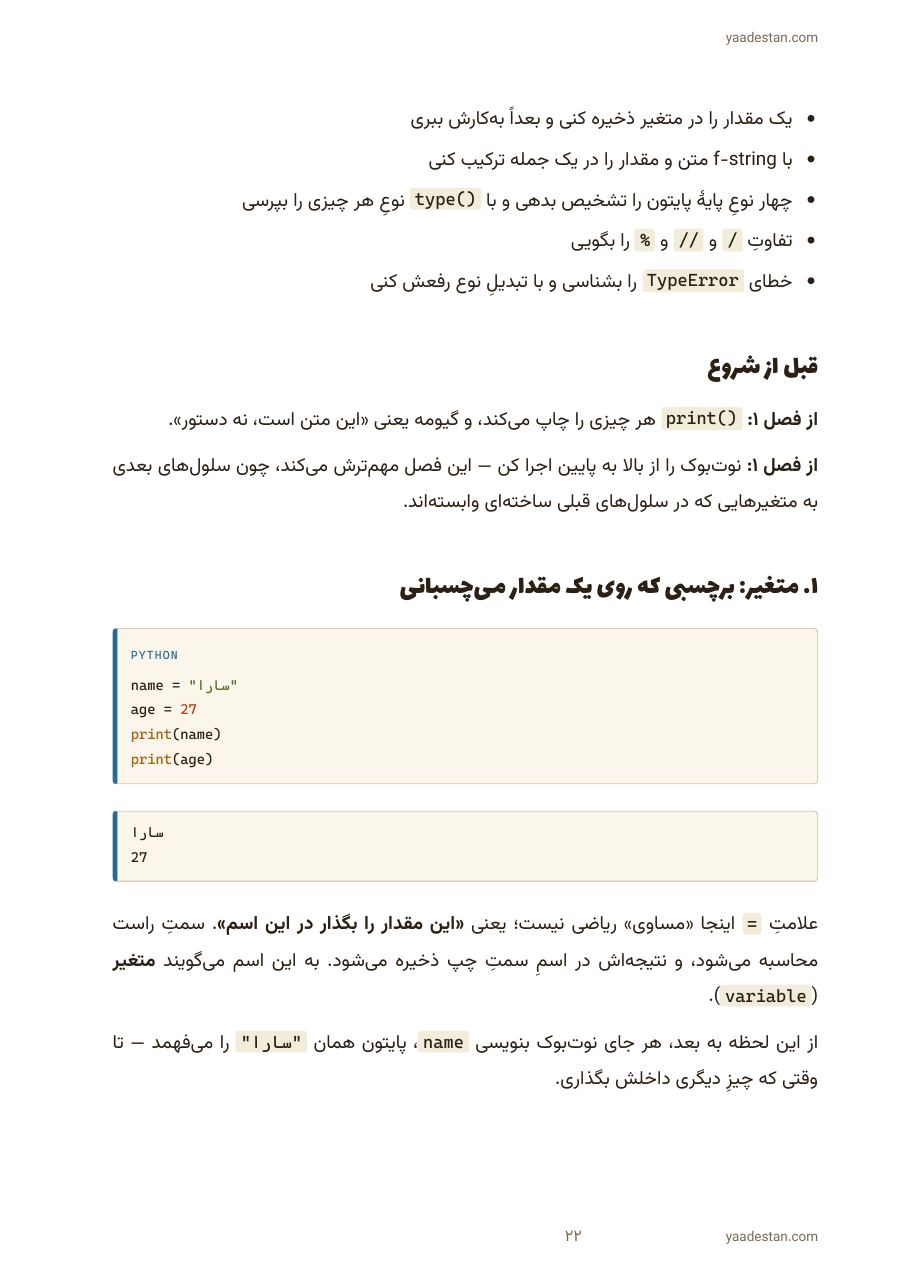 صفحهٔ ۲۲
فهرست مطالب
- ترم ۱ — پایتون از صفر، داخلِ Colab۱۰
- اولین سلول: پایتون در مرورگر۱۰
- مقدار، متغیر، نوع۲۱
- فهرست: وقتی یک مقدار کافی نیست۳۲
- دیکشنری: دادهای که اسم دارد۴۶
- شرط: کد تصمیم میگیرد۵۷
- حلقه: کد تکرار میکند۶۷
- تابع: به کدت اسم بده۷۸
- خطا دشمن نیست: خواندنِ traceback۹۰
- دستیارِ هوش مصنوعی: همکار، نه جایگزین۱۰۰
- چرا نوتبوک دروغ میگوید۱۱۰
- پروژه: یک ابزارِ متنیِ واقعی۱۲۲
- ترم ۲ — داده: دیدن، تمیز کردن، فهمیدن۱۳۸
- چرا آرایه: اولین قدمِ کارِ داده۱۳۸
- کارِ برداری: حلقه ننویس۱۵۰
- `DataFrame`: جدولِ واقعی در پایتون۱۶۱
- انتخاب، فیلتر، ستونِ تازه۱۷۴
- دادهٔ کثیف: کارِ واقعی از اینجا شروع میشود۱۸۴
- گروهبندی: از ردیف به بینش۱۹۹
- نمودار: کدام شکل برای کدام سؤال۲۱۰
- «اول داده را ببین»: تحلیلِ اکتشافی۲۲۴
- دادهٔ متنیِ فارسی۲۳۶
- پروژه: یک دیتاستِ واقعی، از فایلِ خام تا گزارش۲۵۳
- ترم ۳ — اولین مدلها: یادگیری ماشین۲۶۹
- یادگیری ماشین یعنی چه۲۶۹
- اولین مدل: از داده تا پیشبینی۲۸۰
- خطِ پایه: قبل از هر مدلی۲۹۱
- نشتیِ داده: چرا عددت دروغ میگوید۳۰۳
- طبقهبندی: جوابِ بله-خیر۳۱۶
- `accuracy` دروغ میگوید۳۳۰
- پیشپردازش بدونِ نشتی: `Pipeline`۳۴۳
- حفظکردن در برابرِ یادگرفتن: `overfitting`۳۵۸
- تنظیمِ مدل بدونِ خرابکردنِ تست۳۷۰
- درخت، جنگل، boosting۳۸۵
- تحلیلِ خطا: به ردیفهای غلط نگاه کن۳۹۷
- پروژه: از سؤال تا مدلِ ارزیابیشده۴۱۰
- ترم ۴ — مدلهای آماده: وقتی لازم نیست خودت آموزش بدهی۴۳۰
- مدلِ آماده یعنی چه۴۳۰
- Hugging Face در سه خط۴۴۳
- اولین فراخوانیِ API از پایتون۴۵۵
- خروجیِ ساختارمند: از متن به داده۴۶۸
- `embedding`: معنا به زبانِ عدد۴۸۱
- جستوجوی معنایی، از پایه۴۹۴
- توکن، هزینه، و مرزها۵۱۳
- پروژه: یک دستیارِ پرسشوپاسخ روی متنهای خودت۵۲۹
- ترم ۵ — از نوتبوک تا چیزی که دیگران استفاده میکنند۵۴۶
- تکرارپذیری: نتیجهای که فردا هم همان است۵۴۶
- از نوتبوک به فایلِ `.py`۵۶۱
- نسخهبندی: `git` از داخلِ Colab۵۸۰
- تست: چرا کدِ داده هم تست میخواهد۵۹۸
- رابط: مدلت را قابلِاستفاده کن۶۱۵
- انتشار روی Hugging Face Spaces۶۲۹
- صداقت بعد از انتشار۶۴۶
- پروژهٔ پایانی: از سؤال تا اپِ منتشرشده۶۵۹
از میز خوانندهها
یادداشتها و پرسشها
ستارهها را فقط کسانی میدهند که آن را خریدهاند و یادداشتشان مهر «خریدار» دارد. پرسیدن دربارهٔ آن برای همه آزاد است و نوشتهٔ اول هر کس پیش از انتشار خوانده میشود.
یادداشتها بعد از بارگذاری صفحه نشان داده میشوند.