فایل آموزشی
آموزش یادگیری عمیق با پایتون و PyTorch؛ بینایی ماشین، ترنسفورمر و مهندسی LLM (خودآموز ژرفا)
خودآموز یادگیری عمیق در سطح متوسط: ساختن و آموزش شبکهٔ عصبی با PyTorch، آموزش درست مدل، بینایی ماشین، پردازش زبان و ترنسفورمر، fine-tune مدل آماده و ساختن سامانهٔ LLM با ارزیابی واقعی. همه در Google Colab. خودآموز دانلودی کامل و مستقل با جواب تمرینها؛ قالب PDF، EPUB و MOBI، دانلود از حساب کاربری پس از پرداخت.
امتیاز خریدارهای این خودآموز
هنوز امتیازی نیست
میانگین از سومین امتیاز
- ۵ ستاره: ۰ نفر
- ۴ ستاره: ۰ نفر
- ۳ ستاره: ۰ نفر
- ۲ ستاره: ۰ نفر
- ۱ ستاره: ۰ نفر
- قیمت
- ۳۹۹٬۰۰۰ تومان
- قالب
- PDF · EPUB · MOBI
- تعداد صفحه
- ۸۶۷
- حجم
- ۳۱٫۲ مگابایت
- زبان
- فارسی
برای خرید حساب کاربری لازم است و فایل بعد از پرداخت در حساب من میماند.
هر فایل به نام خریدارش آماده میشود: شمارهٔ موبایل و شناسهٔ حساب با خطی ریز در حاشیهٔ صفحهها میآید. برای کاربرانِ زیر ۱۸ سال، بخشی از شماره پوشانده میشود.
این فایل نسخهٔ دانلودی خودآموز ژرفا — خودآموز یادگیری عمیق و مهندسی هوش مصنوعی (متوسط) است.
دربارهٔ این فایل
نسخهٔ دانلودی خودآموز «ژرفا — خودآموز یادگیری عمیق و مهندسی هوش مصنوعی (متوسط)» با ۵۱ فصل و ۸۶۷ صفحه.
خودآموزی کامل و مستقل با جوابِ تمرینها: برای خواندن و تمرین به سایت نیازی نیست. فهرست کامل و چند صفحهٔ نمونه را همینجا ببین.
پیشنمایش
این تصویرها چند صفحه از همین فایلاند.
 صفحهٔ ۲
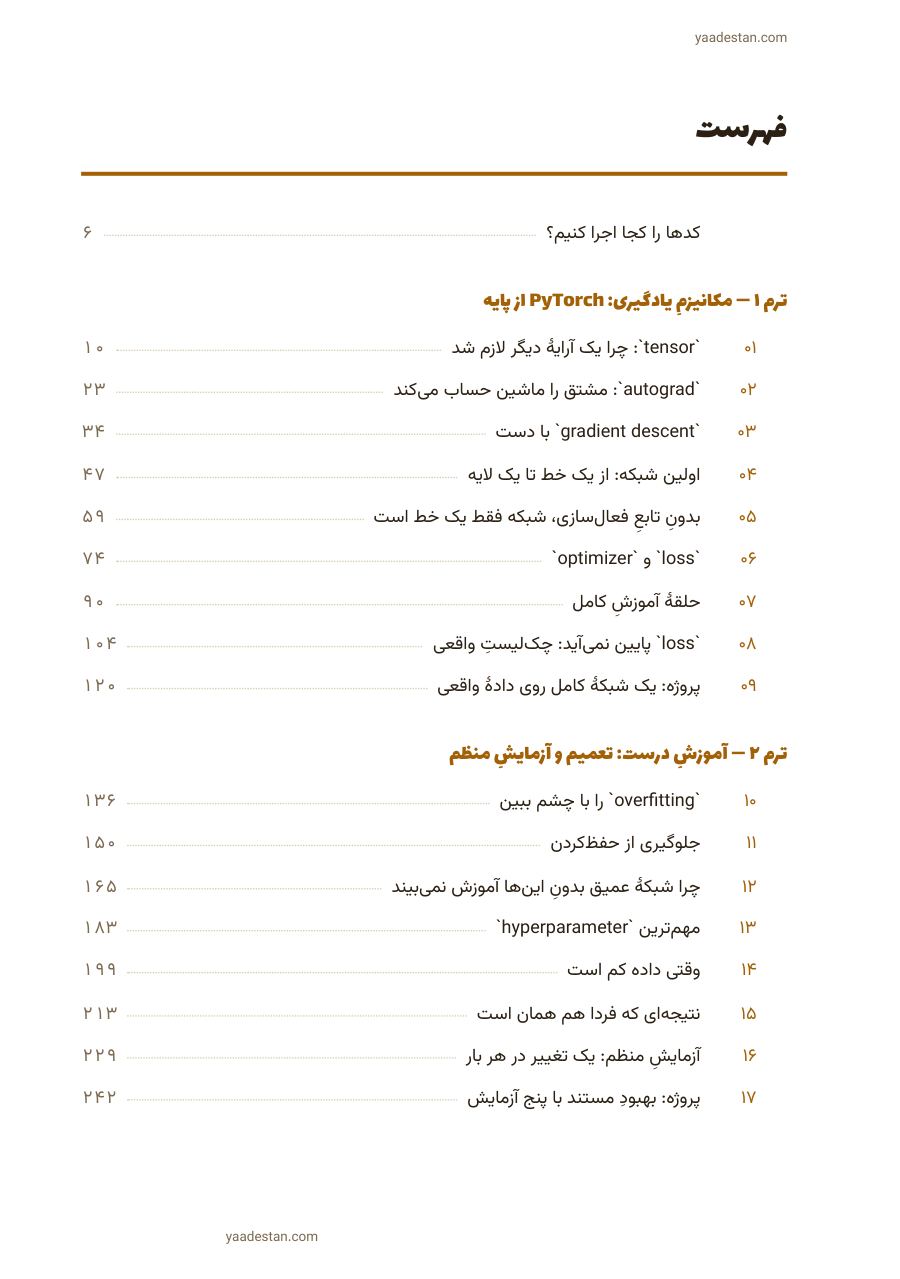 صفحهٔ ۳
 صفحهٔ ۱۰
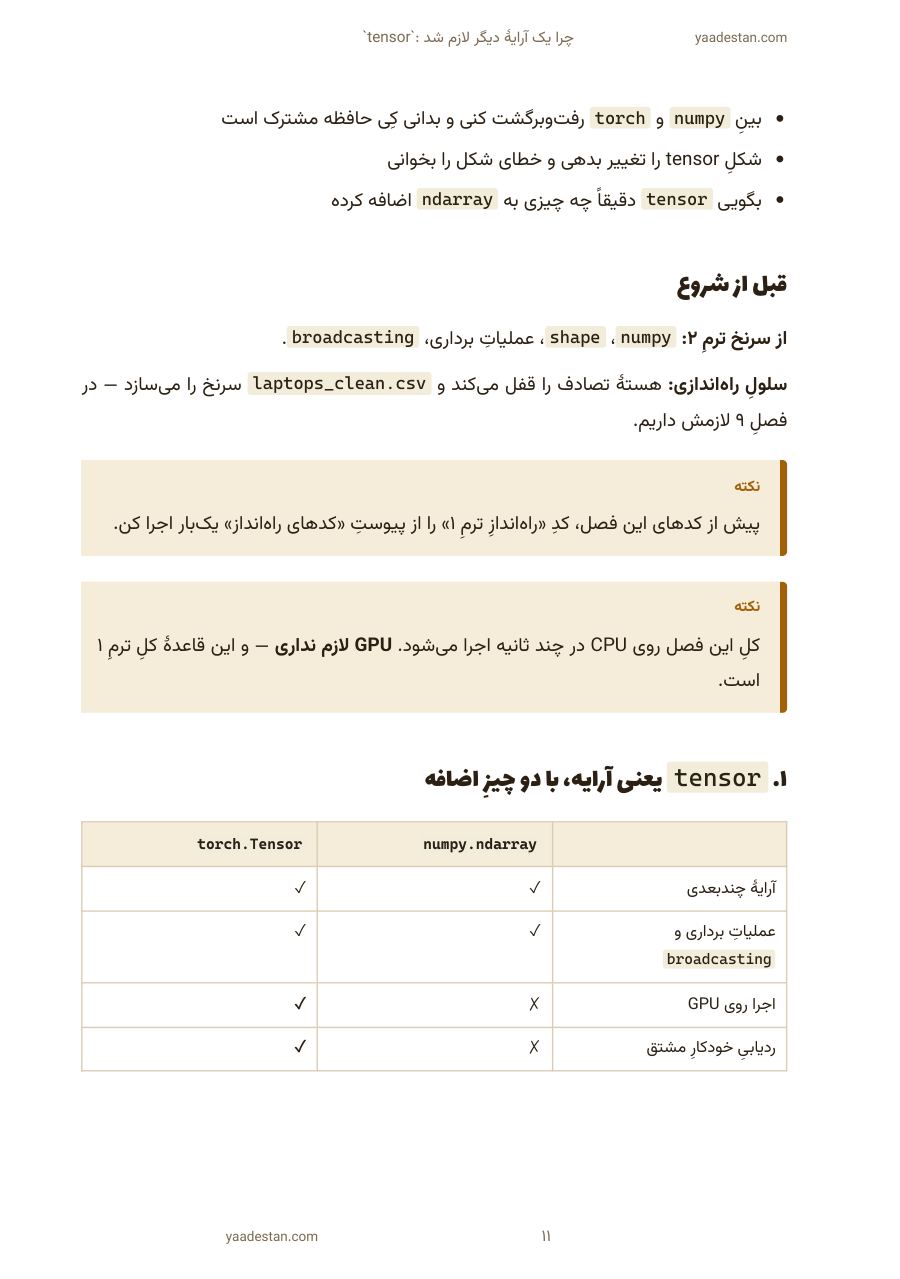 صفحهٔ ۱۱
 صفحهٔ ۲۳
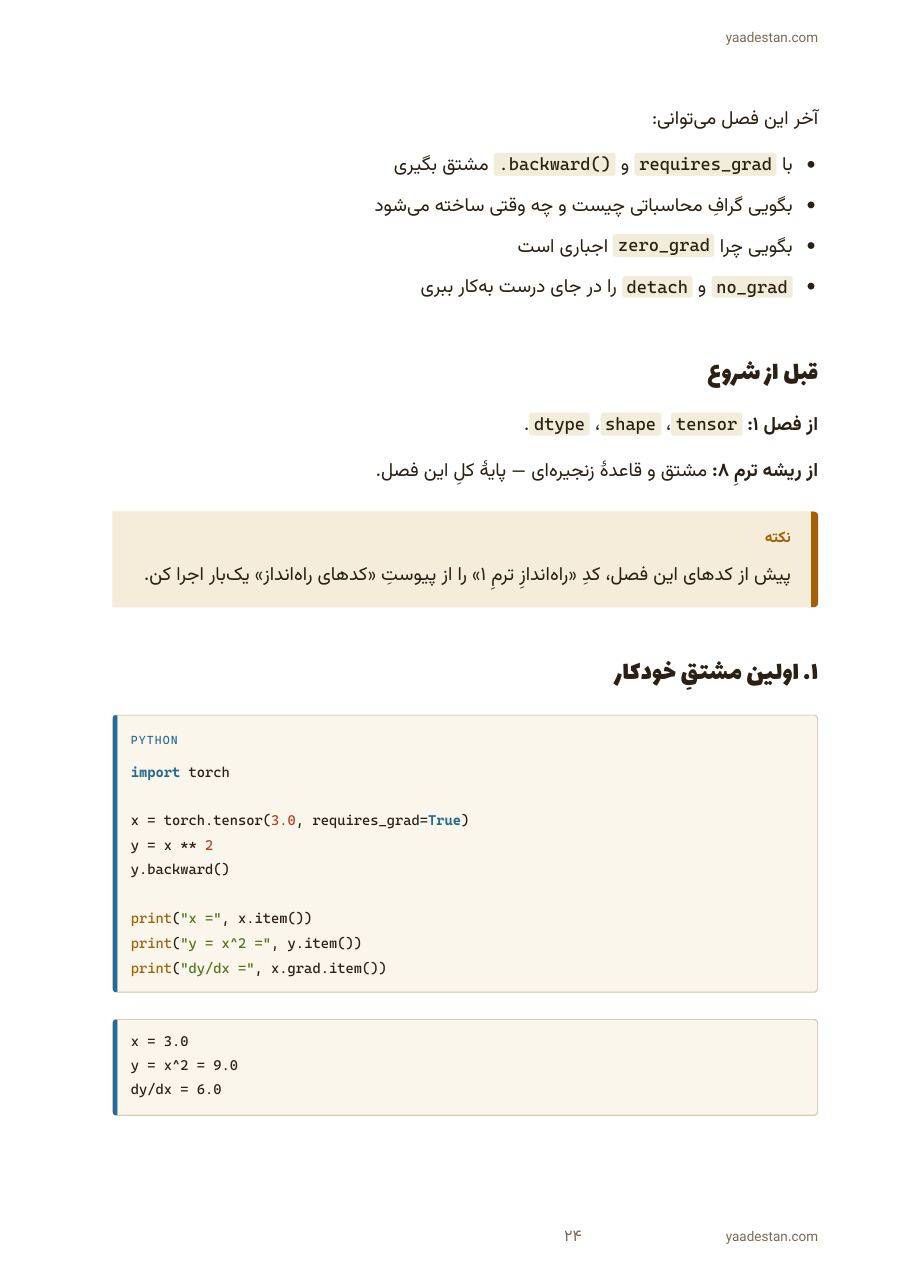 صفحهٔ ۲۴
فهرست مطالب
- ترم ۱ — مکانیزمِ یادگیری: PyTorch از پایه۱۰
- `tensor`: چرا یک آرایهٔ دیگر لازم شد۱۰
- `autograd`: مشتق را ماشین حساب میکند۲۳
- `gradient descent` با دست۳۴
- اولین شبکه: از یک خط تا یک لایه۴۷
- بدونِ تابعِ فعالسازی، شبکه فقط یک خط است۵۹
- `loss` و `optimizer`۷۴
- حلقهٔ آموزشِ کامل۹۰
- `loss` پایین نمیآید: چکلیستِ واقعی۱۰۴
- پروژه: یک شبکهٔ کامل روی دادهٔ واقعی۱۲۰
- ترم ۲ — آموزشِ درست: تعمیم و آزمایشِ منظم۱۳۶
- `overfitting` را با چشم ببین۱۳۶
- جلوگیری از حفظکردن۱۵۰
- چرا شبکهٔ عمیق بدونِ اینها آموزش نمیبیند۱۶۵
- مهمترین `hyperparameter`۱۸۳
- وقتی داده کم است۱۹۹
- نتیجهای که فردا هم همان است۲۱۳
- آزمایشِ منظم: یک تغییر در هر بار۲۲۹
- پروژه: بهبودِ مستند با پنج آزمایش۲۴۲
- ترم ۳ — دیدن: CNN و انتقالِ یادگیری۲۵۶
- تصویر یعنی عدد۲۵۶
- `convolution`: چرا لایهٔ تماممتصل جواب نمیدهد۲۶۶
- معماریِ یک CNN۲۷۹
- مدلِ آماده روی دادهٔ خودت۲۹۱
- `fine-tuning` در برابرِ `feature extraction`۳۰۶
- دامهای دادهٔ تصویری۳۲۱
- مدل به چه نگاه میکند۳۳۸
- پروژه: طبقهبندِ تصویر روی دادهٔ خودت۳۵۲
- ترم ۴ — زبان: از `embedding` تا `transformer`۳۷۰
- متن به عدد۳۷۰
- فضای `embedding`: معنا و سوگیری۳۸۶
- ترتیب مهم است۴۰۴
- `attention`: قلبِ ماجرا۴۲۰
- بلوکِ `transformer`، تکهتکه۴۳۸
- `tokenizer`: چرا فارسی گران است۴۵۳
- یک مدلِ زبانیِ خیلی کوچک را خودت آموزش بده۴۶۹
- یک مدلِ آمادهٔ چندزبانه روی فارسی: ویژگیگیری و `fine-tune`۴۸۶
- پروژه: مدلِ متنِ فارسیِ خودت۵۰۳
- ترم ۵ — مهندسیِ LLM: سامانهای که واقعاً کار میکند۵۲۴
- API یک مدلِ بزرگ، از پایتون۵۲۴
- خروجیِ ساختارمند و اعتبارسنجیشده۵۴۲
- `tool calling`: مدل تابعِ تو را صدا میزند۵۶۱
- `RAG` از صفر، بدونِ framework۵۷۹
- `RAG` خراب میشود — کجا و چرا۵۹۵
- `eval`: مهمترین فصلِ این ترم۶۰۴
- عامل: حلقهٔ فکر و عمل۶۲۶
- هزینه، تأخیر، `cache`۶۴۸
- ایمنی: `prompt injection` و دادهٔ حساس۶۷۰
- پروژه: سامانهٔ `RAG` فارسی با `eval`۶۹۱
- ترم ۶ — تخصصیشدن و مسیرِ بعدی۷۱۴
- `fine-tuning` کارآمد: `LoRA`۷۱۴
- `quantization` و مدلِ محلی۷۳۴
- مدلِ چندوجهی در عمل۷۵۵
- تولیدِ تصویر: `diffusion`۷۷۶
- سرو کردنِ مدل۷۹۳
- مسئولیتِ مهندس۸۱۵
- پروژهٔ نهایی: یک سامانهٔ کامل۸۳۵
از میز خوانندهها
یادداشتها و پرسشها
ستارهها را فقط کسانی میدهند که آن را خریدهاند و یادداشتشان مهر «خریدار» دارد. پرسیدن دربارهٔ آن برای همه آزاد است و نوشتهٔ اول هر کس پیش از انتشار خوانده میشود.
یادداشتها بعد از بارگذاری صفحه نشان داده میشوند.