شبکه عصبی چیست؟ از یک نورون تا مدلهای امروزی، به زبان ساده
شبکه عصبی (neural network) تابعی است که ورودی را لایهبهلایه با تعداد زیادی عددِ قابلتنظیم به خروجی تبدیل میکند، و این عددها، که به آنها وزن میگویند، بهجای آنکه دستی نوشته شوند از روی داده تنظیم میشوند. داخلِ آن فقط ضرب و جمع و چند تابعِ سادهٔ دیگر است. مدلهای زبانی هم شبکهٔ عصبیاند، فقط بسیار بزرگتر و با ساختاری پیچیدهتر.
اسمش از مغز آمده، ولی برای فهمیدنش به زیستشناسی نیاز نداری. اینجا یک نورون را با دست حساب میکنیم، با سهتا از آنها چیزی میسازیم که یک نورون نمیتواند، و بعد میبینیم آموزش دقیقاً چه میکند.
یک نورون: جمعِ وزندار و یک تصمیم
نورونِ مصنوعی چند عدد میگیرد و یک عدد میدهد. سه مرحله دارد:
- هر ورودی را در یک وزن (
weight) ضرب میکند. - همه را جمع میزند و یک عددِ ثابت به نامِ
biasبه آن اضافه میکند. - حاصل را از یک تابع فعالسازی (
activation function) رد میکند.
z = w1 × x1 + w2 × x2 + b
y = activation(z)
وزن میگوید هر ورودی چقدر مهم است و bias میگوید نورون چقدر راحت فعال میشود. سادهترین تابع فعالسازی یک پله است: اگر z مثبت بود خروجی 1، وگرنه 0.
با w1 = 1، w2 = 1 و b = -0.5، این نورون منطقِ OR را میسازد. با b = -1.5 منطقِ AND را:
x1 |
x2 |
z نورون OR |
خروجی OR | z نورون AND |
خروجی AND |
|---|---|---|---|---|---|
0 |
0 |
-0.5 |
0 |
-1.5 |
0 |
0 |
1 |
0.5 |
1 |
-0.5 |
0 |
1 |
0 |
0.5 |
1 |
-0.5 |
0 |
1 |
1 |
1.5 |
1 |
0.5 |
1 |
چیزی برنامهنویسی نکردیم. فقط چند عدد عوض شد و رفتار عوض شد. این ایدهٔ مرکزیِ همهٔ ماجراست.
چرا یک نورون کافی نیست
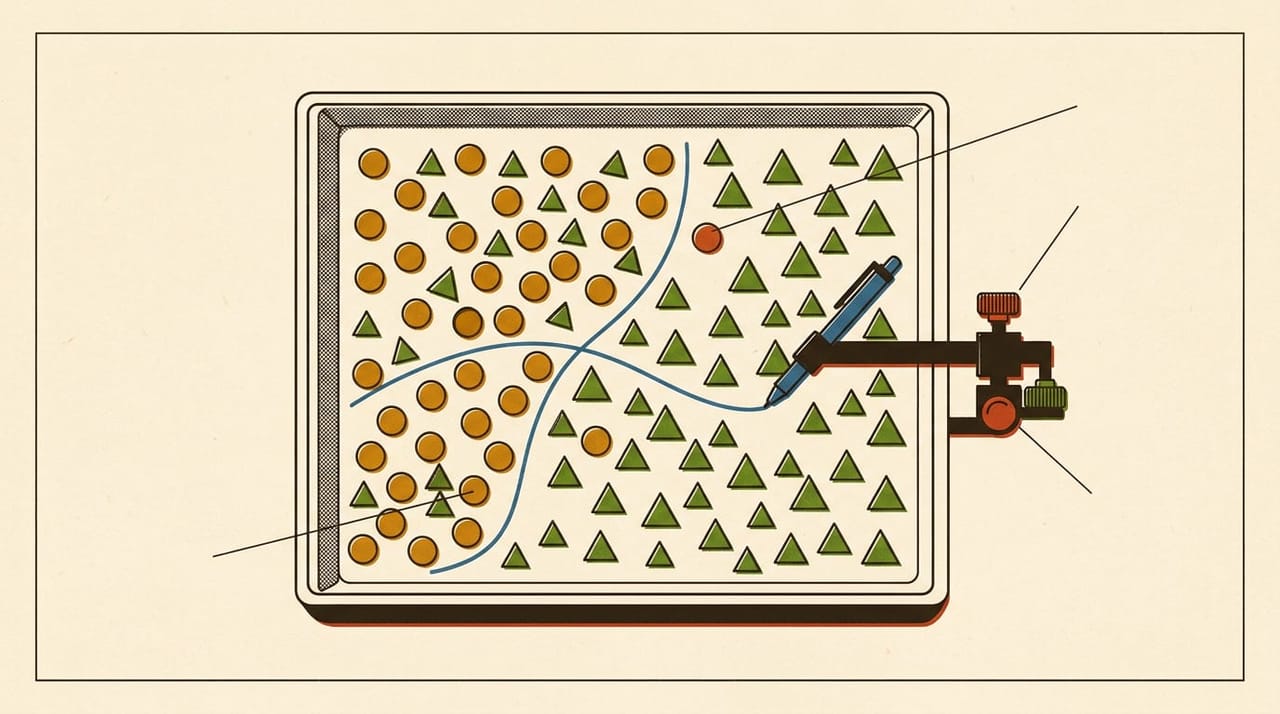
حالا XOR را بخواه: خروجی 1 فقط وقتی دو ورودی متفاوت باشند. هر چقدر وزنها را عوض کنی، یک نورونِ پلهای نمیتواند این را بسازد. دلیلش هندسی است: یک نورون فضای ورودی را با یک خطِ راست به دو طرف تقسیم میکند، و نقطههای XOR با یک خط جدا نمیشوند.
راهحل یک لایهٔ دیگر است. خروجیِ OR و AND را به نورونِ سومی میدهیم:
z3 = OR − AND − 0.5
x1 |
x2 |
OR | AND | z3 |
خروجی |
|---|---|---|---|---|---|
0 |
0 |
0 |
0 |
-0.5 |
0 |
0 |
1 |
1 |
0 |
0.5 |
1 |
1 |
0 |
1 |
0 |
0.5 |
1 |
1 |
1 |
1 |
1 |
-0.5 |
0 |
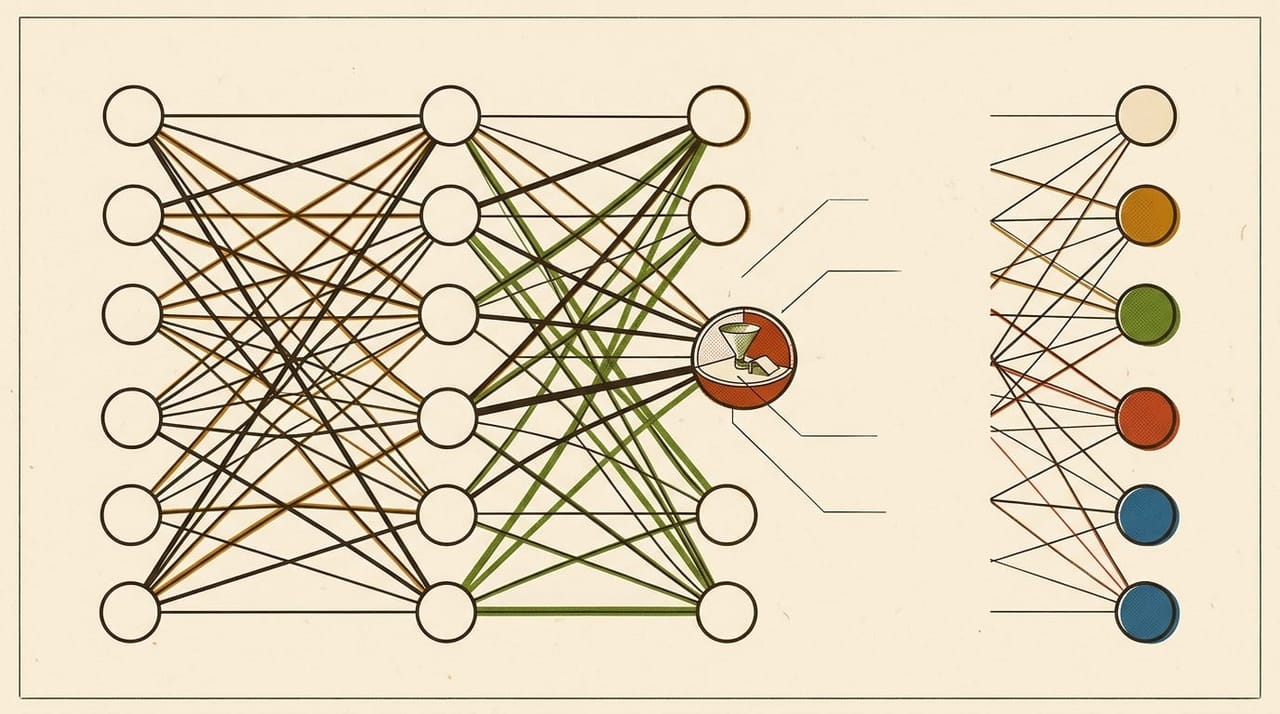
این یک شبکهٔ عصبیِ کامل است: دو ورودی، یک لایهٔ پنهان با دو نورون، و یک نورونِ خروجی. نورونهای لایهٔ پنهان ویژگیهای میانی ساختند و لایهٔ بعد از آنها استفاده کرد.
قدرتِ شبکه از لایههاست: هر لایه از خروجیِ لایهٔ قبل ویژگی تازهای میسازد.
چرا تابع فعالسازی لازم است
شاید بگویی پله را حذف کنیم و فقط ضرب و جمع بماند. مشکل این است که ترکیبِ چند تابعِ خطی باز هم خطی است:
g(x) = 3x + 1
h(x) = 2x + 5
h(g(x)) = 2(3x + 1) + 5 = 6x + 7
اگر فعالسازیِ غیرخطی نباشد، هزار لایه هم در نهایت معادلِ یک خطِ راست است و عمق هیچ فایدهای ندارد. تابعِ غیرخطی همان چیزی است که اجازه میدهد شبکه منحنی بسازد.
در شبکههای واقعی از پله استفاده نمیشود، چون آموزش به مشتق نیاز دارد و پله تقریباً همهجا شیبِ صفر دارد. بهجایش توابعی مثلِ ReLU و sigmoid به کار میروند. ReLU خیلی ساده است: عددِ منفی را صفر میکند و عددِ مثبت را همانطور رد میکند.
لایهها و شمردن پارامترها
یک شبکهٔ معمولی از لایههایی ساخته میشود که هر نورونشان به همهٔ نورونهای لایهٔ قبل وصل است. بهجز لایهٔ ورودی و خروجی، بقیه را لایهٔ پنهان میگویند. وقتی لایههای پنهان زیاد باشند، به آن یادگیری عمیق (deep learning) میگویند.
هر عددی که با آموزش تنظیم میشود یک پارامتر است. شمردنشان ساده است. هر نورون بهازای هر ورودی یک وزن دارد و یک bias. شبکهٔ XOR بالا: هر کدام از سه نورون ۲ وزن و ۱ bias دارد، پس ۹ پارامتر.
یک مثالِ کلاسیک: تشخیصِ رقمِ دستنویس از تصویرِ 28×28. یعنی ۷۸۴ ورودی، یک لایهٔ پنهانِ ۱۲۸تایی و ۱۰ خروجی:
(784 × 128) + 128 = 100,480
(128 × 10)  + 10  =   1,290
                جمع = 101,770
حدودِ صد هزار عدد برای یک مسئلهٔ کوچک. هیچکس اینها را با دست نمینویسد. پس سؤالِ اصلی این است: چطور پیدا میشوند؟
آموزش: چهار مرحله که تکرار میشوند
یادگیری ماشین دقیقاً همین تنظیمِ خودکار است. آموزش یک حلقهٔ چهارمرحلهای است:
- پیشبینی (
forward). ورودی از شبکه رد میشود و خروجی درمیآید. - سنجش خطا (
loss). یک عدد میگوید خروجی چقدر با جوابِ درست فاصله دارد. - پسانتشار (
backpropagation). الگوریتمی با قاعدهٔ زنجیرهایِ مشتق حساب میکند هر وزن چقدر در خطا سهم داشته. - بهروزرسانی (
gradient descent). هر وزن کمی در جهتِ کمشدنِ خطا جابهجا میشود.
کوچکترین نمونهٔ ممکن: یک وزن، y = w × x. داده میگوید برای x = 2 جوابِ درست 6 است، پس w باید 3 شود، ولی شبکه این را نمیداند و از w = 1 شروع میکند.
خطا را (y − 6)² میگیریم. مشتقش نسبت به w برابرِ 2 × (y − 6) × x است و در هر قدم 0.05 برابرِ مشتق را از w کم میکنیم:
| قدم | w |
پیشبینی y |
خطا | مشتق | w جدید |
|---|---|---|---|---|---|
| ۱ | 1 |
2 |
16 |
-16 |
1.8 |
| ۲ | 1.8 |
3.6 |
5.76 |
-9.6 |
2.28 |
| ۳ | 2.28 |
4.56 |
2.0736 |
-5.76 |
2.568 |
خطا در سه قدم از 16 به حدودِ 2 رسید و w دارد به 3 نزدیک میشود. یک شبکهٔ واقعی همین کار را همزمان برای میلیونها وزن و روی دادههای زیاد انجام میدهد. منطق همان است.
خانوادههای شبکهٔ عصبی
| نوع | ایده | کاربرد معمول |
|---|---|---|
| لایههای کاملاً متصل | هر نورون به همهٔ نورونهای قبلی وصل است | دادهٔ جدولی و مسئلههای ساده |
CNN |
الگوهای کوچک را در سراسر تصویر پیدا میکند | پردازش تصویر |
RNN |
داده را قدمبهقدم با حافظهٔ درونی میخواند | دنبالهها، پیش از غلبهٔ transformer |
Transformer |
هر تکه با attention به تکههای دیگر نگاه میکند |
مدلهای زبانی و بسیاری از کاربردهای امروزی |
چیزی که ChatGPT و مدلهای مشابه با آن کار میکنند، یک transformer است که روی token ها آموزش دیده.
چیزهایی که شبکه عصبی نیست
- مغز نیست. نورونِ مصنوعی یک فرمولِ ساده است. الهام از مغز آمده، ولی شباهتش به نورونِ واقعی سطحی است.
- حافظهٔ جدولمانند نیست. مدل جوابها را در یک فهرست نگه نمیدارد؛ الگوها در وزنها پخش شدهاند. برای همین میتواند با اطمینان اشتباه کند.
- بهراحتی توضیحپذیر نیست. میتوانی هر عدد را ببینی، ولی معمولاً نمیشود گفت چرا مجموعِ میلیونها عدد این تصمیم را گرفته.
- همیشه انتخابِ درست نیست. برای دادههای جدولیِ کوچک، روشهای سادهتر اغلب کافیاند و ارزانتر تمام میشوند.
یک نتیجهٔ نظری هم هست که زیاد نقل میشود: شبکهای با یک لایهٔ پنهان و نورونِ کافی میتواند هر تابعِ پیوسته را روی یک بازهٔ محدود تا دقتِ دلخواه تقریب بزند. این فقط میگوید چنین وزنهایی وجود دارند، نه اینکه آموزش حتماً پیدایشان میکند.
در کد چه شکلی است
شبکهای برای XOR در PyTorch، با دو ورودی، چهار نورونِ پنهان و یک خروجی:
import torch.nn as nn

model = nn.Sequential(
    nn.Linear(2, 4),
    nn.ReLU(),
    nn.Linear(4, 1),
)

total = sum(p.numel() for p in model.parameters())
print(total)  # 17
nn.Linear(2, 4) یعنی ۲ ورودی به ۴ نورون: 2×4 + 4 = 12 پارامتر. لایهٔ بعد 4×1 + 1 = 5 پارامتر. جمع 17. همان شمارشی که با دست کردیم.
جمعبندی
شبکهٔ عصبی لایهلایه ضرب و جمع است با یک تابعِ غیرخطی بینشان، و تواناییاش از عددهایی میآید که با تکرارِ «پیشبینی، سنجش خطا، اصلاح» تنظیم شدهاند. اگر میخواهی بعدِ این توضیح خودت یکی بسازی و آموزش بدهی، خودآموز ژرفا از همین مکانیزم با PyTorch شروع میکند. و اگر هنوز نمیدانی از کجا شروع کنی، نقشهٔ راه یادگیری هوش مصنوعی کمک میکند.
اگر میخواهی این موضوع را کامل یاد بگیری

خودآموز یادگیری عمیق و مهندسی هوش مصنوعی (متوسط)
زیر سطحِ ابزارهایی که تا حالا فقط استفاده میکردی. با PyTorch شبکه میسازی و آموزش میدهی، transformer را بلوکبهبلوک میفهمی، مدل آماده را fine-tune میکنی، و یک سامانهٔ LLM با eval واقعی میسازی — همه در Google Colab.
- ۶ ترم
- ۵۱ فصل
- همهٔ فصلها رایگان