یادگیری عمیق چیست و چه فرقی با یادگیری ماشین دارد؟
یادگیری عمیق (Deep Learning) شاخهای از یادگیری ماشین است که از شبکههای عصبی با لایههای زیاد استفاده میکند. «عمیق» به تعداد لایهها اشاره دارد، نه به عمیقتر بودن فهم. در یادگیری ماشین کلاسیک معمولاً خودت ویژگیهای مهم داده را انتخاب میکنی؛ در یادگیری عمیق، لایهها خودشان ویژگیها را از داده خام یاد میگیرند. این روش برای تصویر، صدا و متن عالی است، ولی داده و توان محاسباتی زیادی میخواهد.
یادگیری ماشین چه بود؟
اگر هنوز نمیدانی، اول یادگیری ماشین چیست را بخوان. خلاصه: بهجای نوشتن قاعده، به برنامه مثال میدهی تا الگو را بیاموزد. مثلاً میخواهی قیمت یک خانه را پیشبینی کنی. ویژگیهایی مثل متراژ، تعداد اتاق و محله را خودت انتخاب میکنی و به یک مدل ساده میدهی. این روش در دادههای جدولی عالی کار میکند.
مشکل از جایی شروع میشود که ورودی تصویر است. یک عکس یعنی هزاران عدد پیکسل. «ویژگی»اش چیست؟ نمیتوانی با چند قاعده بنویسی «گوش گربه چه شکلی است». اینجا یادگیری عمیق به کار میآید.
شبکهٔ عصبی و لایه یعنی چه؟
یک شبکهٔ عصبی (neural network) از واحدهای کوچکی ساخته میشود که هر کدام کار سادهای میکنند: چند عدد ورودی را در وزنهایشان ضرب میکنند، جمع میزنند و از یک تابع ساده (تابع فعالسازی، activation) رد میکنند. چندین واحد کنار هم یک لایه (layer) میسازند. خروجی هر لایه ورودی لایهٔ بعد است. شرح کاملتر در شبکهٔ عصبی چیست آمده است.
هر شبکه سه نوع لایه دارد:
- لایهٔ ورودی: داده را میگیرد (مثلاً پیکسلها).
- لایههای پنهان (
hidden layers): میانراهها، که الگو میسازند. - لایهٔ خروجی: جواب را میدهد (مثلاً «گربه» یا «سگ»).
«عمیق» یعنی چه؟
شبکهای که فقط یک لایهٔ پنهان دارد «کمعمق» حساب میشود. وقتی چندین لایهٔ پنهان پشت سر هم میگذاری، شبکه را «عمیق» مینامند. بسیاری از شبکههای امروزی دهها تا صدها لایه دارند.
چرا لایههای بیشتر مفید است؟ چون هر لایه روی خروجی لایهٔ قبلی میسازد. در یک شبکهٔ تشخیص تصویر معمولاً چنین چیزی دیده میشود:
- لایههای اول: لبهها و خطهای ساده
- لایههای میانی: ترکیب لبهها به شکلهای کوچک، مثل گوشه یا دایره
- لایههای آخر: ترکیب شکلها به اجزای بزرگ، مثل چشم یا چرخ، و بعد به کل شیء
این سلسلهمراتب از ساده به پیچیده را شبکه خودش از مثالها یاد میگیرد؛ تو آن را برنامهریزی نکردهای.
یک شبکهٔ کوچک در PyTorch اینطور نوشته میشود:
import torch
from torch import nn

model = nn.Sequential(
    nn.Linear(784, 128),
    nn.ReLU(),
    nn.Linear(128, 10),
)

total = sum(p.numel() for p in model.parameters())
print(total)
خروجی 101770 است. این شبکه ورودی ۷۸۴ تایی میگیرد (مثل عکس ۲۸×۲۸ پیکسلی که ردیفهایش پشت هم گذاشته شده)، یک لایهٔ پنهان با ۱۲۸ واحد دارد و ۱۰ خروجی میدهد. حساب پارامترها: لایهٔ اول ۷۸۴×۱۲۸ + ۱۲۸ = ۱۰۰٬۴۸۰، لایهٔ دوم ۱۲۸×۱۰ + ۱۰ = ۱۲۹۰، و جمع ۱۰۱٬۷۷۰. (این هنوز یک شبکهٔ «کمعمق» است؛ فقط نشان میدهد چطور لایهها ساخته و شمرده میشوند.) فصل اولین شبکه در خودآموز ژرفا همین nn.Linear را قدمبهقدم میسازد.
CNN در یک پاراگراف
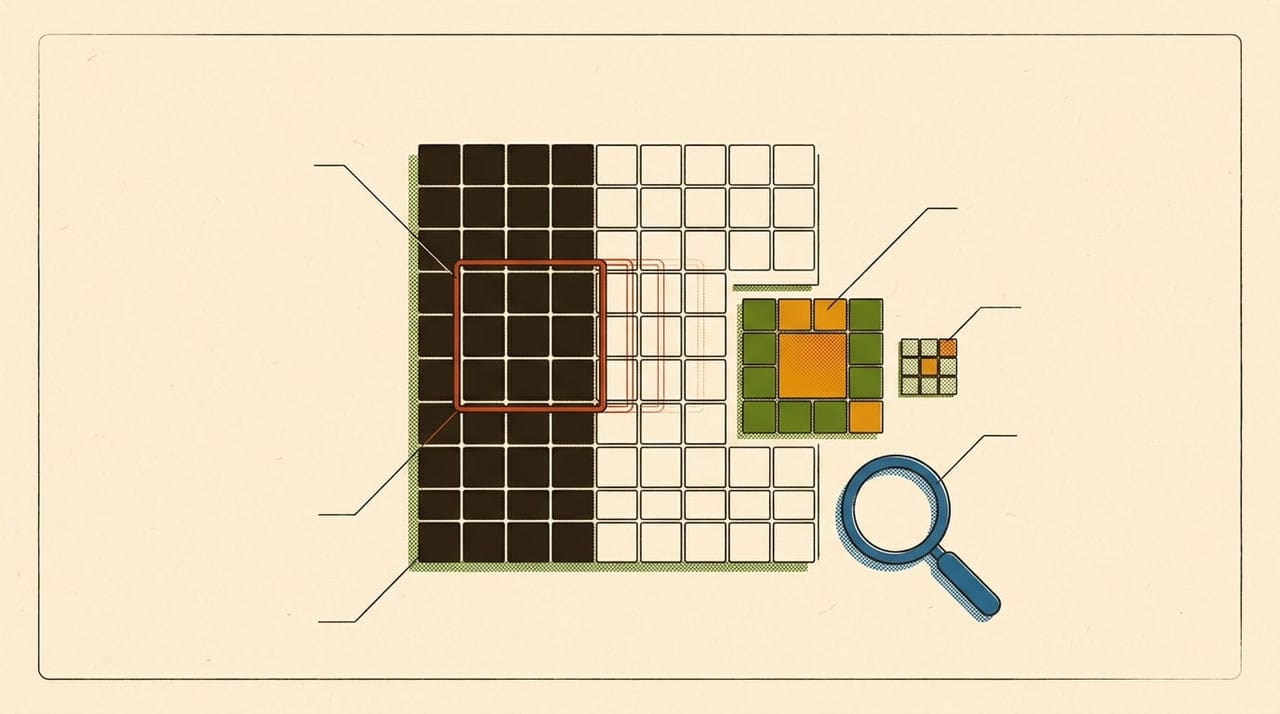
برای تصویر، لایهٔ معمولی که هر ورودی را به همهٔ واحدها وصل میکند بسیار پرهزینه است. شبکهٔ کانولوشنی (CNN، Convolutional Neural Network) بهجای آن از یک فیلتر کوچک (مثلاً ۳×۳) استفاده میکند که روی تصویر سُر میخورد و در هر جا دنبال همان الگو میگردد. چون همان فیلتر (همان وزنها) در همهجا به کار میرود، پارامترها خیلی کمتر میشوند: یک فیلتر ۳×۳ فقط ۹ وزن بهعلاوهٔ یک بایاس دارد، یعنی ۱۰ پارامتر؛ و ۳۲ فیلتر روی تصویر خاکستری ۳۲۰ پارامتر. مزیت دیگر: اگر گربه در تصویر جابهجا شود، همان فیلتر در جای تازه هم الگو را پیدا میکند. مثال عددی قدمبهقدمش را در شبکه عصبی کانولوشن (CNN) چیست ببین، و فصل کانولوشن در خودآموز ژرفا همین را با کد و عدد نشان میدهد.
فرق یادگیری ماشین و یادگیری عمیق در یک نگاه
| یادگیری ماشین کلاسیک | یادگیری عمیق | |
|---|---|---|
| ویژگیها | معمولاً خودت انتخاب میکنی | شبکه از داده خام یاد میگیرد |
| داده لازم | کم تا متوسط | معمولاً زیاد |
| محاسبه | سبک، روی لپتاپ | سنگین، اغلب GPU |
| مناسب برای | جدولها و دادههای ساده | تصویر، صدا، متن |
| توضیحپذیری | معمولاً راحتتر | سختتر |
| مثال | درخت تصمیم، رگرسیون | CNN، ترنسفورمر |
مدلهای زبانی بزرگ مثل چتباتهای امروز هم نوعی یادگیری عمیقاند (بر پایهٔ معماری ترنسفورمر). برای ادامه: مدلهای زبانی چطور کار میکنند.
کِی به یادگیری عمیق نیاز دارم؟
- ورودی تصویر، صدا یا متن آزاد است.
- داده زیاد داری یا میتوانی از مدل از پیش آموزشدیده کمک بگیری.
- مسئله آنقدر پیچیده است که قاعدهٔ ساده و ویژگی دستی کفایت نمیکند.
و کِی لازم نیست؟ اگر دادهات جدول کوچکی با چند ستون است، مدلهای سادهتر (رگرسیون یا درخت) معمولاً سریعتر، ارزانتر و قابلفهمترند و اغلب نتیجهٔ مشابه یا بهتر میدهند. یادگیری عمیق همیشه «بهتر» نیست؛ ابزار مناسب یک کار خاص است.
اشتباههای رایج
- «عمیق یعنی عمیقتر میفهمد.» نه؛ فقط لایههای بیشتر دارد.
- «همیشه از یادگیری عمیق استفاده کن.» برای دادههای کوچک ممکن است بیشبرازش (
overfitting) رخ دهد، یعنی شبکه مثالها را حفظ کند. - «اگر شبکه کار کرد، یعنی چراییاش را میدانیم.» نه؛ تفسیر درونی شبکههای عمیق سخت است.
- فراموش کردن کیفیت داده. شبکه از همان دادهای که میبیند یاد میگیرد؛ داده بد، مدل بد میدهد.
سؤالهای رایج
یادگیری عمیق چیست؟
روشی از یادگیری ماشین که با شبکههای عصبی چندلایه الگوها را مستقیم از داده خام (مثل پیکسل یا متن) یاد میگیرد.
چرا به آن «عمیق» میگویند؟
چون شبکه لایههای پنهان زیادی دارد؛ عمق یعنی تعداد لایهها.
فرق یادگیری عمیق و یادگیری ماشین چیست؟
یادگیری عمیق زیرمجموعهای از یادگیری ماشین است. در یادگیری ماشین کلاسیک ویژگیها را معمولاً خودت میسازی؛ در یادگیری عمیق شبکه آنها را یاد میگیرد.
آیا برای یادگیری عمیق به کامپیوتر قوی نیاز دارم؟
برای تمرین کوچک نه، اما آموزش مدلهای بزرگ GPU میخواهد. برای شروع، سرویسهای ابری و نوتبوکها کافیاند.
اگر میخواهی این موضوع را کامل یاد بگیری

خودآموز یادگیری عمیق و مهندسی هوش مصنوعی (متوسط)
زیر سطحِ ابزارهایی که تا حالا فقط استفاده میکردی. با PyTorch شبکه میسازی و آموزش میدهی، transformer را بلوکبهبلوک میفهمی، مدل آماده را fine-tune میکنی، و یک سامانهٔ LLM با eval واقعی میسازی — همه در Google Colab.
- ۶ ترم
- ۵۱ فصل
- همهٔ فصلها رایگان