شبکه عصبی کانولوشن (CNN) چیست؟ به زبان ساده
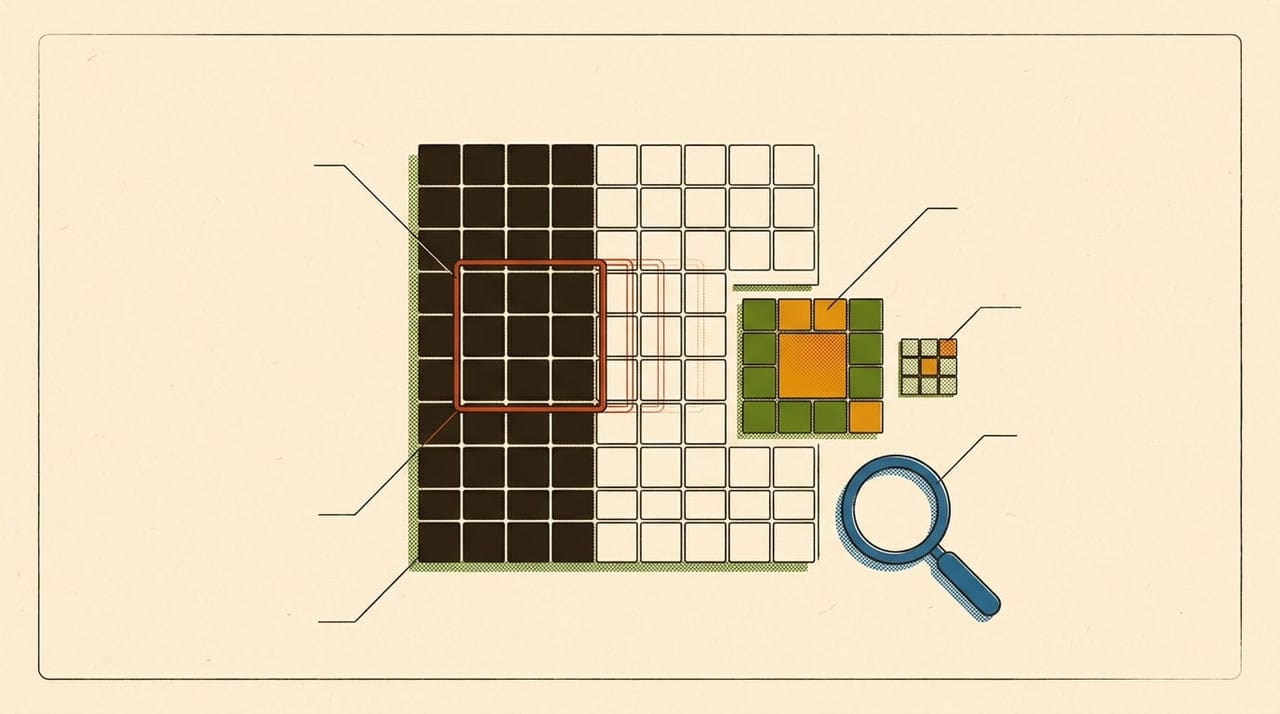
شبکه عصبی کانولوشن (Convolutional Neural Network، یا CNN) نوعی شبکه عصبی است که مخصوص تصویر ساخته شده: فیلترهای کوچکی (مثلاً ۳×۳) روی تصویر میلغزند و در هر جا حساب میکنند «آیا این الگو (مثل یک لبه) اینجا هست؟»؛ شبکه این فیلترها را خودش در آموزش یاد میگیرد و لایهبهلایه از لبهها به شکلها و بعد به اشیا میرسد. چون یک فیلتر در کل تصویر دوباره استفاده میشود، پارامتر خیلی کمتری از شبکهٔ معمولی لازم دارد.
تصویر برای کامپیوتر چیست؟
تصویر خاکستری فقط یک جدول عدد است. هر خانه (پیکسل) یک عدد از 0 (سیاه) تا 255 (سفید) دارد. تصویر 28×28 یعنی ۷۸۴ عدد. تصویر رنگی سه جدول دارد (قرمز، سبز، آبی).
اگر این عددها را مستقیم به یک شبکهٔ معمولی بدهی، هر پیکسل به هر نورون یک وزن جدا دارد. در خودآموز ژرفا حساب میکنیم: لایهٔ معمولی Linear با ۷۸۴ ورودی و ۳۲ خروجی ۲۵٬۱۲۰ پارامتر دارد، در حالی که لایهٔ کانولوشن با ۳۲ فیلتر ۳×۳ فقط ۳۲۰ پارامتر (۹ وزن و یک بایاس برای هر فیلتر). حدود ۷۸ برابر کمتر. و بدتر: شبکهٔ معمولی نمیداند پیکسلهای کنار هم به هم ربط دارند؛ لبهای که در گوشهٔ چپ یاد گرفته در گوشهٔ راست دوباره از صفر یاد میگیرد.
کانولوشن یعنی چه؟ یک فیلتر که میلغزد
یک فیلتر (به آن کرنل هم میگویند) جدول کوچکی از عددهاست. کار کانولوشن این است:
- فیلتر را روی گوشهٔ بالا-چپ تصویر بگذار.
- هر عدد فیلتر را در پیکسل زیرش ضرب کن.
- همهٔ حاصلضربها را جمع کن؛ یک عدد میشود.
- آن عدد را در خانهٔ متناظر خروجی بنویس.
- فیلتر را یک خانه به راست ببر و تکرار کن. وقتی ردیف تمام شد، یک خانه پایین برو.
مثال عددی قدمبهقدم
تصویر 6×6 را در نظر بگیر که نیمهٔ چپش تیره (0) و نیمهٔ راستش روشن (9) است. یعنی یک لبهٔ عمودی وسطش دارد:
| 0 | 0 | 0 | 9 | 9 | 9 |
| 0 | 0 | 0 | 9 | 9 | 9 |
| 0 | 0 | 0 | 9 | 9 | 9 |
| 0 | 0 | 0 | 9 | 9 | 9 |
| 0 | 0 | 0 | 9 | 9 | 9 |
| 0 | 0 | 0 | 9 | 9 | 9 |
این فیلتر 3×3 برای پیدا کردن «تیره در چپ، روشن در راست» ساخته شده:
| −1 | 0 | 1 |
| −1 | 0 | 1 |
| −1 | 0 | 1 |
خانهٔ اول خروجی (فیلتر روی ستونهای ۱ تا ۳). در هر سه ردیفِ زیر فیلتر، عددها 0 0 0 است:
per row: (−1×0 + 0×0 + 1×0) = 0
3 rows:  0 + 0 + 0 = 0
خانهٔ دوم (فیلتر یک خانه به راست، ستونهای ۲ تا ۴). هر ردیف 0 0 9 است:
per row: (−1×0 + 0×0 + 1×9) = 9
3 rows:  9 + 9 + 9 = 27
خانهٔ سوم (ستونهای ۳ تا ۵): هر ردیف 0 9 9:
per row: (−1×0 + 0×9 + 1×9) = 9
3 rows:  9 + 9 + 9 = 27
خانهٔ چهارم (ستونهای ۴ تا ۶): هر ردیف 9 9 9:
per row: (−1×9 + 0×9 + 1×9) = 0
3 rows:  0 + 0 + 0 = 0
چون همهٔ ردیفهای تصویر یکیاند، هر چهار ردیف خروجی هم یکی میشود. خروجی 4×4:
| 0 | 27 | 27 | 0 |
| 0 | 27 | 27 | 0 |
| 0 | 27 | 27 | 0 |
| 0 | 27 | 27 | 0 |
اعداد بزرگ (27) دقیقاً جاییاند که لبه بود. جاهای صاف (همهٔ 0 یا همهٔ 9) صفر شدند. فیلتر «آشکارساز لبهٔ عمودی» است.
اندازهٔ خروجی هم قاعده دارد: اگر تصویر n×n و فیلتر k×k باشد و فیلتر یک خانه یک خانه بلغزد، خروجی (n − k + 1) در (n − k + 1) است. اینجا 6 − 3 + 1 = 4.
نکته: در این مثال خودمان فیلتر را دستساز گذاشتیم. در یک CNN واقعی، عددهای فیلتر را شبکه در آموزش خودش پیدا میکند. هیچکس به شبکه نمیگوید «لبه را اینطور پیدا کن»؛ از هزاران تصویر درمییابد کدام فیلترها به کارش میآید. (در کتابخانهها معمولاً فیلتر را برعکس نمیکنند، که از نظر ریاضی دقیقاً «همبستگی متقابل» است؛ ولی همه به آن کانولوشن میگویند و برای ما فرقی نمیکند.)
Pooling: خلاصه کردن
بعد از کانولوشن، معمولاً لایهٔ pooling میآید تا اندازه را کم کند. رایجترینش max pooling است: تصویر را به بلوکهای 2×2 تقسیم کن و از هر بلوک فقط بزرگترین عدد را نگه دار.
خروجی بالا (4×4) را max pooling میکنیم. بلوک چپ-بالا شامل 0 27 / 0 27 است و بزرگتریناش 27. بلوک راست-بالا 27 0 / 27 0 است و بزرگتریناش باز 27. نتیجه 2×2:
| 27 | 27 |
| 27 | 27 |
اندازه به یکچهارم رسید (۱۶ عدد به ۴ عدد)، ولی این اطلاعات حفظ شد: «در این ناحیه یک لبهٔ عمودی دیده شد.» pooling دو فایده دارد: محاسبات کمتر میشود، و شبکه نسبت به جابهجایی کوچک الگو بیتفاوتتر میشود (لبه یک خانه آنطرفتر بود هم تشخیص داده میشود).
یک CNN کامل چه شکلی است؟
چند مرحله را پشت هم میگذارند:
- کانولوشن + فعالسازی: فیلترهای متعدد، هر کدام یک الگو. (رایجترین تابع فعالسازی، ReLU، عددهای منفی را صفر میکند تا شبکه بتواند چیزهای پیچیدهتر از یک خط صاف یاد بگیرد.)
- Pooling: کوچک کردن.
- تکرار چند بار. لایههای اول لبه و بافت، لایههای بعدی چشم و چرخ و گوش، لایههای آخر کل شیء را میبینند.
- لایههای معمولی در انتها، که از ویژگیهای پیداشده تصمیم میگیرند: «گربه ۹۲٪، سگ ۶٪».
چرا CNN برای تصویر خوب است؟
- پارامتر کم: یک فیلتر در کل تصویر استفاده میشود (همان
۳۲۰در برابر۲۵٬۱۲۰). - الگو هر جا باشد پیدا میشود: اگر شبکه یاد گرفت لبه را کجا بیابد، همان فیلتر در هر جای تصویر کار میکند.
- ساختار تصویر را رعایت میکند: پیکسلهای همسایه کنار هم بررسی میشوند، نه بهصورت یک ردیف بیربط عدد.
CNNها هنوز پایهٔ بسیاری از کارهای بینایی ماشیناند: تشخیص چهره، خواندن پلاک، تشخیص بیماری در عکس پزشکی.
ادامه بده
در خودآموز رایگان ژرفا، فصل کانولوشن همین ایده را با کد PyTorch میسازد و جابهجایی را با عدد ثابت میکند، و فصل معماری CNN لایهها را کنار هم میچیند. اگر در ابتدای راه یادگیری ماشینی هستی، فصلهای ترم ۱ همان خودآموز شبکهٔ ساده را از صفر میسازد.
سؤالهای رایج
کانولوشن یعنی چه؟
لغزاندن یک فیلتر کوچک روی تصویر؛ در هر جا فیلتر را در پیکسلهای زیرش ضرب و جمع میکنیم تا یک عدد درآید. عدد بزرگ یعنی الگوی فیلتر آنجا هست.
فیلتر در CNN را چه کسی تعیین میکند؟
شبکه خودش در آموزش، با دیدن تصویرهای زیاد. ما فقط اندازهٔ فیلتر و تعدادشان را انتخاب میکنیم.
pooling چه کاری میکند؟
اندازهٔ تصویر ویژگیها را کم میکند (مثلاً از هر بلوک 2×2 بزرگترین عدد) تا محاسبات کم شود و شبکه نسبت به جابهجایی کوچک حساس نباشد.
چرا برای تصویر از شبکهٔ معمولی استفاده نمیکنیم؟
چون پارامتر بسیار زیاد میخواهد و نمیداند پیکسلهای همسایه به هم مربوطاند؛ CNN با اشتراکگذاری فیلتر هر دو مشکل را حل میکند.
CNN فقط برای تصویر است؟
بیشتر برای تصویر، ولی برای صدا، متن و دادههای ردیفی هم به کار میرود.
اگر میخواهی این موضوع را کامل یاد بگیری

خودآموز یادگیری عمیق و مهندسی هوش مصنوعی (متوسط)
زیر سطحِ ابزارهایی که تا حالا فقط استفاده میکردی. با PyTorch شبکه میسازی و آموزش میدهی، transformer را بلوکبهبلوک میفهمی، مدل آماده را fine-tune میکنی، و یک سامانهٔ LLM با eval واقعی میسازی — همه در Google Colab.
- ۶ ترم
- ۵۱ فصل
- همهٔ فصلها رایگان