انحراف معیار چیست؟ فرمول، مثال قدمبهقدم و معنی واقعیاش
انحراف معیار (standard deviation) عددی است که میگوید دادهها بهطور معمول چقدر از میانگینشان فاصله دارند. انحراف معیارِ کوچک یعنی دادهها دورِ میانگین جمع شدهاند و انحراف معیارِ بزرگ یعنی پراکندهاند. برای دادههای 2, 4, 4, 4, 5, 5, 7, 9 میانگین 5 و انحراف معیار دقیقاً 2 است.
پس میانگین میگوید مرکز کجاست و انحراف معیار میگوید چقدر میشود به آن مرکز اعتماد کرد. اگر با میانگین، میانه و مد آشنایی، این تکهٔ بعدیِ همان پازل است.
چرا میانگین بهتنهایی کافی نیست
نمرهٔ پنج نفر در دو کلاس:
| کلاس | نمرهها | میانگین |
|---|---|---|
| الف | 12, 13, 14, 15, 16 |
14 |
| ب | 6, 10, 14, 18, 22 |
14 |
میانگین یکی است، ولی کلاسها اصلاً شبیه هم نیستند. در الف همه نزدیکِ هماند و در ب کلاس از هم پاشیده. دامنه یعنی بیشینه منهای کمینه هم کمک میکند، ولی فقط دو عددِ انتهایی را میبیند. انحراف معیار همهٔ دادهها را به حساب میآورد.
ساختن ایده، قدمبهقدم
میخواهیم «فاصلهٔ معمول از میانگین» را اندازه بگیریم. طبیعیترین فکر این است که فاصلهها را میانگین بگیریم. با دادههای کلاس الف:
−2, −1, 0, +1, +2 → جمع = 0
جمعِ فاصلههای علامتدار از میانگین همیشه صفر است. این تصادف نیست؛ تعریفِ میانگین همین است. منفیها و مثبتها هم را خنثی میکنند، پس باید علامت را حذف کنیم. راهِ رایج، بهتواندورساندن است، و بعد جذر میگیریم تا به واحدِ خودِ داده برگردیم.
چهار قدم:
- میانگین را حساب کن.
- فاصلهٔ هر داده از میانگین را به توان دو برسان.
- این مربعها را میانگین بگیر. به این عدد واریانس (
variance) میگویند. - از واریانس جذر بگیر.
σ = √( Σ(x − μ)² / n )
μ میانگین است، n تعدادِ دادهها، Σ یعنی جمع، و σ را «سیگما» میخوانند.
یک مثال کامل
دادهها: 2, 4, 4, 4, 5, 5, 7, 9. جمعشان 40 است و تعدادشان 8، پس میانگین 5.
| داده | فاصله از میانگین | مربع فاصله |
|---|---|---|
2 |
-3 |
9 |
4 |
-1 |
1 |
4 |
-1 |
1 |
4 |
-1 |
1 |
5 |
0 |
0 |
5 |
0 |
0 |
7 |
2 |
4 |
9 |
4 |
16 |
جمعِ مربعها 32 است:
واریانس = 32 / 8 = 4
انحراف معیار = √4 = 2
حالا برگردیم سرِ دو کلاس. برای الف، جمعِ مربعها 10 است و انحراف معیار √2، یعنی حدودِ 1.41. برای ب، جمعِ مربعها 160 است و انحراف معیار √32، یعنی حدودِ 5.66. فاصلههای کلاس ب چهار برابرِ الفاند و انحراف معیارش هم دقیقاً چهار برابر است.
چرا مربع، نه قدر مطلق؟
سؤالِ خوبی است. میشد از قدر مطلق فاصلهها میانگین گرفت. این کار واقعاً معیاری معتبر است و mean absolute deviation نام دارد؛ برای کلاس الف میشود 1.2، و حتی سادهتر هم فهمیده میشود.
انحراف معیار به این دلیل رایجتر شده که ریاضیِ مربعها خوشرفتارتر است. مثلاً واریانسِ مجموعِ دو متغیرِ مستقل برابرِ مجموعِ واریانسهایشان است، و در تحلیل و بهینهسازی راحتتر با آن کار میشود. پس اگر فکر میکنی مربعکردن کمی دلبخواهی است، درست فکر میکنی؛ دلیلش راحتیِ ریاضی است، نه اینکه تنها راهِ درست باشد.
چرا در آخر جذر؟ چون واریانس واحدِ مربع دارد. اگر دادهها به سانتیمتر باشند، واریانس به «سانتیمتر مربع» است که برای فاصله از میانگین معنای روشنی ندارد. جذر، واحد را به واحدِ داده برمیگرداند.
فرق n و n−1: جامعه یا نمونه
گاهی در فرمول بهجای n میبینی n − 1. این اشتباهِ چاپی نیست:
| وضعیت | تقسیم بر | نماد رایج | برای دادههای بالا |
|---|---|---|---|
| همهٔ جامعه را داری | n |
σ |
2 |
| فقط یک نمونه داری و میخواهی جامعه را تخمین بزنی | n − 1 |
s |
حدودِ 2.14 |
دلیلِ شهودی این است: میانگینِ نمونه از خودِ همان نمونه بهدست آمده و برای همین به دادههای نمونه نزدیکتر از میانگینِ واقعیِ جامعه است. پس فاصلهها کمی کوچکتر از واقعیت درمیآیند و پراکندگی کمبرآورد میشود. تقسیم بر n − 1 این را جبران میکند. نامش تصحیحِ Bessel است.
عملاً اگر دادهها زیاد باشند، تفاوتِ این دو ناچیز میشود. ولی نرمافزارها پیشفرضهای متفاوتی دارند و این یک دامِ واقعی است:
| ابزار | تقسیم بر n |
تقسیم بر n − 1 |
|---|---|---|
| Excel | STDEV.P |
STDEV.S |
Python (statistics) |
pstdev |
stdev |
| NumPy | np.std(x) (پیشفرض) |
np.std(x, ddof=1) |
| pandas | s.std(ddof=0) |
s.std() (پیشفرض) |
import statistics as st

data = [2, 4, 4, 4, 5, 5, 7, 9]
print(st.mean(data))     # 5
print(st.pstdev(data))   # 2.0
print(st.stdev(data))    # 2.138...
این عدد را چطور بخوانیم
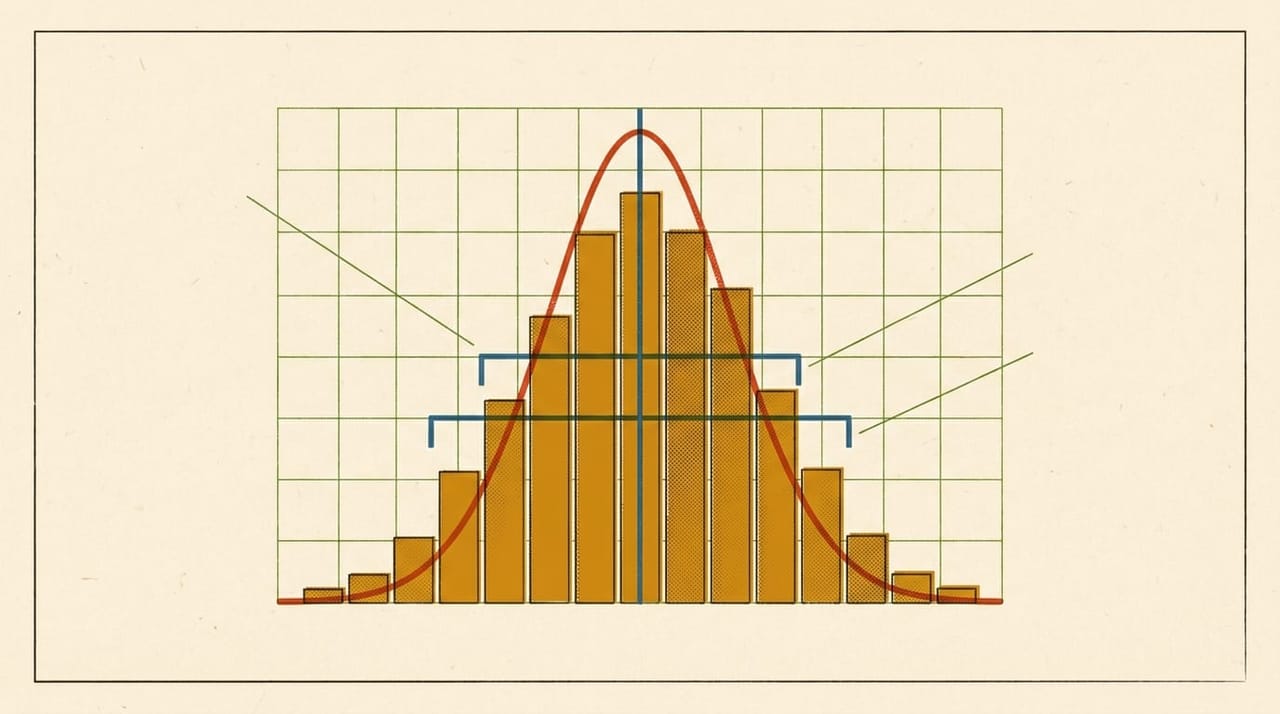
قاعدهٔ ۶۸-۹۵-۹۹٫۷. اگر دادهها توزیعِ نرمال (زنگولهای) داشته باشند، حدودِ ۶۸٪ آنها در فاصلهٔ یک انحراف معیار از میانگیناند، حدودِ ۹۵٪ در فاصلهٔ دو، و حدودِ ۹۹٫۷٪ در فاصلهٔ سه. مثلاً اگر متغیری با میانگینِ 170 و انحراف معیارِ 10 نرمال باشد، حدودِ ۹۵٪ دادهها بینِ 150 و 190 میافتند.
این قاعده فقط برای توزیعِ تقریباً نرمال است. برای هر توزیعی، نامساویِ Chebyshev ضمانتی ضعیفتر ولی همیشگی میدهد: دستکم ۷۵٪ دادهها در فاصلهٔ دو انحراف معیار از میانگیناند.
مقایسهٔ دو نمره با امتیاز z. نمرهٔ 18 در آزمونی با میانگین 15 و انحراف معیار 2، و نمرهٔ 16 در آزمونی با میانگین 14 و انحراف معیار 1. کدام بهتر است؟
z = (x − μ) / σ

z₁ = (18 − 15) / 2 = 1.5
z₂ = (16 − 14) / 1 = 2
نمرهٔ 16 نسبت به همکلاسیهایش بهتر است، با اینکه عددش کوچکتر است. همین تبدیل در یادگیری ماشین هم برای هممقیاسکردنِ دادهها به کار میرود.
رفتارش زیر تبدیل. اگر به همهٔ دادهها عددی اضافه کنی، انحراف معیار عوض نمیشود، چون فاصلهها ثابت ماندهاند. اگر همه را در 10 ضرب کنی، انحراف معیار هم ده برابر میشود. برای همین مقایسهٔ مستقیمِ دو انحراف معیار با واحدهای متفاوت معنا ندارد.
دام اصلی: دادههای پرت
چون فاصلهها به توان دو میرسند، یک دادهٔ خیلی دور اثری نامتناسب دارد. در مثالِ خودمان فقط 9 را به 49 تبدیل کن:
| معیار | دادههای اصلی | با 49 بهجای 9 |
|---|---|---|
| میانگین | 5 |
10 |
| میانه | 4.5 |
4.5 |
| انحراف معیار | 2 |
حدودِ 14.8 |
یک داده عوض شد و انحراف معیار بیش از هفت برابر شد، در حالی که میانه تکان نخورد. پس در دادههای کج، مثلِ درآمد، انحراف معیار بهتنهایی تصویرِ خوبی نمیدهد و بهتر است خودِ توزیع را نگاه کنی.
اشتباههای رایج
- «انحراف معیار یعنی فاصلهٔ میانگینِ دادهها از میانگین.» نزدیک است ولی دقیق نیست؛ آن تعریف مربوط به
mean absolute deviationاست. - بزرگ یعنی بد. نه ذاتاً. پراکندگی فقط توصیف است؛ در یک خطِ تولید بد است و در تنوعِ ورودیهای یک مدل ممکن است خوب باشد.
- قاطیکردن با
standard error. انحراف معیار پراکندگیِ دادههاست؛ خطای استاندارد دقتِ میانگینِ تخمینزدهشده است و با بزرگترشدنِ نمونه کم میشود. - استفاده از قاعدهٔ ۶۸-۹۵ برای هر دادهای. ابتدا شکلِ توزیع را ببین.
جمعبندی
انحراف معیار جوابِ این سؤال است: دادهها معمولاً چقدر از میانگین دورند؟ یک میانگین بگیر، فاصلهها را مربع کن، میانگین بگیر، جذر بزن. فقط یادت باشد n یا n − 1 را از ابزارت بپرسی و به دادههای پرت چشم داشته باشی. در خودآموز ریشه این مفهوم در ترمِ احتمال و آمار، کنارِ میانگین و میانه میآید.
اگر میخواهی این موضوع را کامل یاد بگیری

خودآموز ریاضی از چهار عمل تا هوش مصنوعی
هیچ ایدهٔ پیشرفتهای در ریاضی از هوا نیامده؛ هر کدام ریشهای در چیزی ساده دارد که همین حالا بلدی. از «عدد یعنی چه» شروع میکنیم و به همان ریاضیای میرسیم که هوش مصنوعی با آن آموزش میبیند — بدون حفظکردنِ بیدلیل و بدون فرضِ اینکه قبلاً چیزی بلد بودهای.
- ۸ ترم
- ۷۳ فصل
- همهٔ فصلها رایگان