Big O چیست؟ پیچیدگی زمانی الگوریتم به زبان ساده، با اندازهگیری واقعی
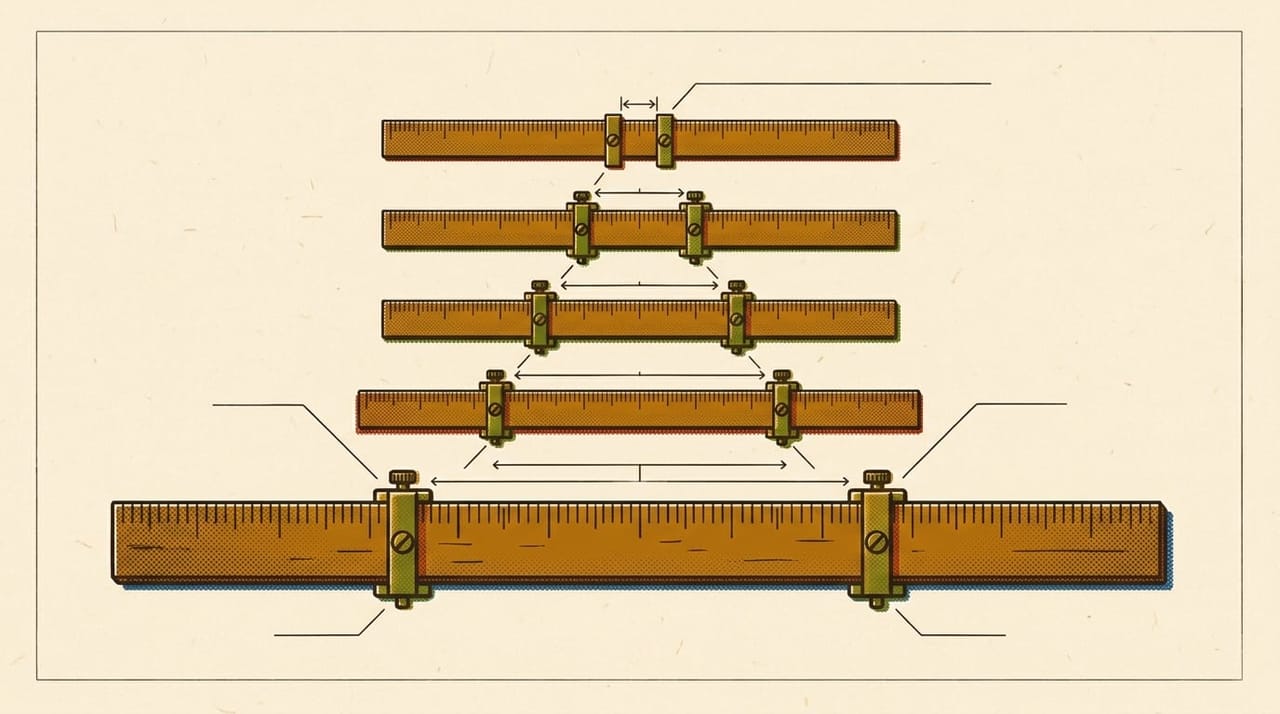
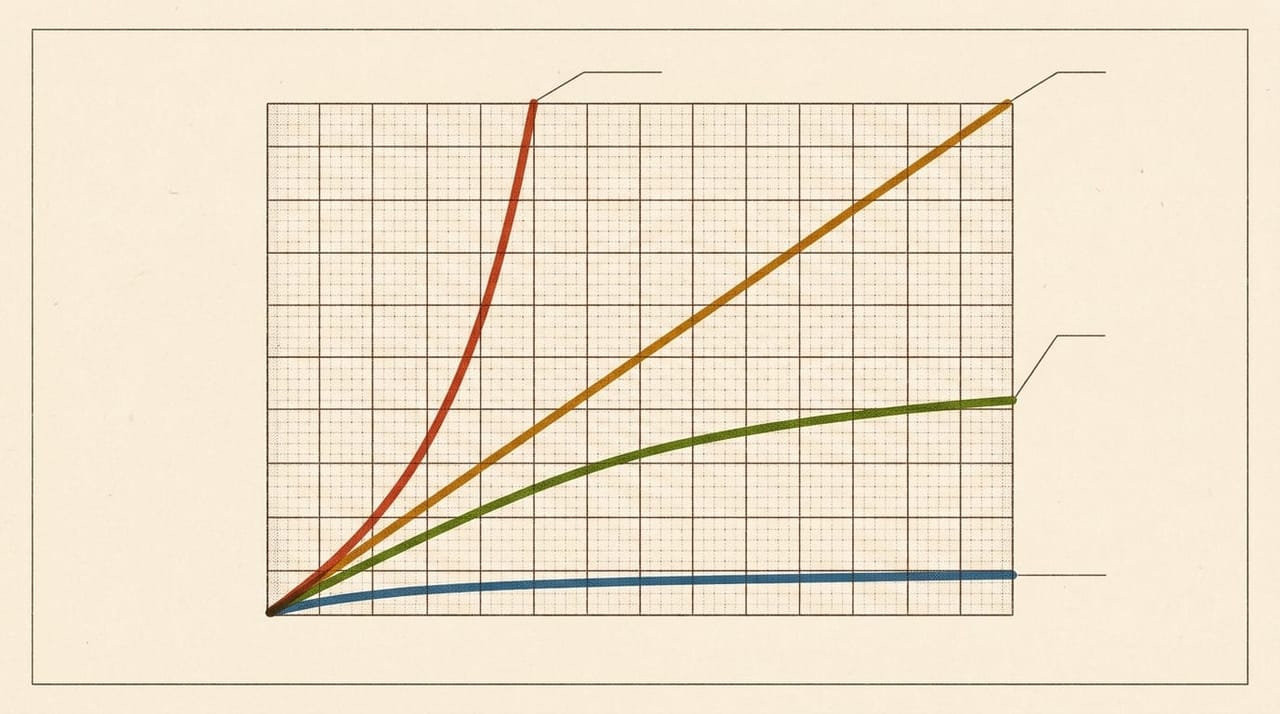
Big O میگوید با بزرگشدن داده، زمان اجرای یک الگوریتم با چه الگویی رشد میکند. O(n) یعنی اگر داده دو برابر شود، زمان هم حدود دو برابر میشود. O(n²) یعنی زمان حدود چهار برابر میشود. Big O زمان را به ثانیه نمیگوید. شکل رشد را میگوید.
یک مسئله، دو راه
میخواهیم بدانیم در یک لیست عدد تکراری هست یا نه. راه اول هر عضو را با همهٔ عضوهای بعدش مقایسه میکند. راه دوم چیزهایی را که دیده در یک set نگه میدارد. این کد هر دو را اندازه میگیرد:
import time

def has_duplicate_slow(items):
    for i in range(len(items)):
        for j in range(i + 1, len(items)):
            if items[i] == items[j]:
                return True
    return False

def has_duplicate_fast(items):
    seen = set()
    for x in items:
        if x in seen:
            return True
        seen.add(x)
    return False

def measure(fn, n):
    data = list(range(n))  # no duplicates: the worst case for both
    start = time.perf_counter()
    fn(data)
    return time.perf_counter() - start

for n in (2_000, 4_000, 8_000):
    print(n, round(measure(has_duplicate_slow, n), 4),
          round(measure(has_duplicate_fast, n), 6))
این عددها از یک اجرای واقعی به ثانیه آمده است. عدد روی دستگاه تو فرق میکند، ولی نسبتها مهماند:
n |
راه اول (O(n²)) |
راه دوم (O(n)) |
|---|---|---|
2000 |
0.0545 |
0.000140 |
4000 |
0.2250 |
0.000207 |
8000 |
0.9088 |
0.000451 |
در راه اول با هر دو برابرشدن، زمان حدود چهار برابر شد. در راه دوم رشد خیلی کندتر است. عددهای راه دوم آنقدر کوچکاند که نویز اندازهگیری در آنها اثر دارد، پس نسبتشان دقیق نیست.
چرا چهار برابر؟ حلقهٔ تودرتو برای n عضو n(n-1)/2 مقایسه انجام میدهد. برای 2000 عضو این عدد 1,999,000 است. اگر n دو برابر شود، تعداد مقایسهها حدود چهار برابر میشود.
Big Oپیشبینی است. داده را دو برابر کن، نسبت زمانها را ببین و بسنج که پیشبینی درست بود یا نه.
پیچیدگیهای رایج
| نماد | وقتی n دو برابر شود |
مثال |
|---|---|---|
O(1) |
تقریباً تغییری نمیکند | خواندن یک عضو لیست با اندیس |
O(log n) |
یک قدم اضافه | جستوجوی دودویی در لیست مرتب |
O(n) |
حدود دو برابر | پیمایش لیست |
O(n log n) |
کمی بیشتر از دو برابر | مرتبسازی با sorted |
O(n²) |
حدود چهار برابر | حلقهٔ تودرتو روی همان داده |
برای حس اندازه، به تعداد قدمها برای یک میلیون داده نگاه کن:
n = 1,000,000 |
|
|---|---|
log₂ n |
حدود 20 |
n |
1,000,000 |
n log₂ n |
حدود 20,000,000 |
n² |
1,000,000,000,000 |
Big O را از روی کد چطور بخوانیم
سه قاعدهٔ کاری کافی است:
- حلقههای پشتسرهم جمع میشوند. دو حلقهٔ جدا روی
nعضو میشود2n، یعنیO(n). - حلقههای تودرتو ضرب میشوند. حلقه در حلقه روی همان داده میشود
O(n²). - ثابتها و جملههای کوچک حذف میشوند.
3n² + 5nهمانO(n²)است، چون درnبزرگ جملهٔ غالب تعیینکننده است.
دامی که در پایتون پنهان است
یک خط کوتاه میتواند خودش یک حلقه باشد:
x in my_list  # scans the list: O(n)
x in my_set   # hash lookup: O(1) on average
روی همان دستگاه و با یک میلیون عضو، جستوجوی عضو آخر در list حدود 9 میلیثانیه طول کشید و در set کمتر از یکهزارم میلیثانیه. اگر این خط داخل یک حلقه باشد، کل کار بیصدا O(n²) میشود. برای همین راه دوم ما سریع است: x in seen روی set است، نه list.
عبارت «بهطور میانگین» هم مهم است. set در بدترین حالت میتواند کندتر شود، و O(1) قول میانگین است.
چیزی که Big O نمیگوید
ثابت پنهان را نمیگوید. الگوریتم O(n) با ثابت بزرگ ممکن است برای دادههای کوچک از O(n²) با ثابت کوچک کندتر باشد. اگر دادهات همیشه ده تاست، الگوریتم ساده شاید بهترین انتخاب باشد.
حافظه را نمیگوید. راه دوم ما سریعتر است، ولی برای set حافظهٔ اضافه مصرف میکند. پیچیدگی حافظه را جدا میسنجند.
خودش نمیگوید کدام حالت است. Big O یک کران بالاست و باید بگویی دربارهٔ کدام حالت حرف میزنی. راه اول اگر تکراری را زود پیدا کند، زود تمام میشود، و برای همین در اندازهگیری دادهای بدون تکرار ساختیم.
جمعبندی
برای هر کد کند، اول اندازه بگیر. داده را دو برابر کن و نسبت زمان را ببین. اگر حدود چهار برابر شد، دنبال حلقهٔ تودرتو یا in روی list بگرد. خودآموز بنیاد با همین قاعده جلو میرود: هیچ ادعای پیچیدگی بدون جدول اندازهگیری. خودآموز دانلودی بنیاد نسخهٔ دانلودی همان دوره است.
اگر میخواهی این موضوع را کامل یاد بگیری

ساختمان داده و الگوریتم، با اندازهگیری واقعی
ساختمان داده و الگوریتم را با پایتون یاد بگیر، با اندازهگیری بهجای حفظکردن. کدت درست کار میکند و روی دادهٔ واقعی غیرقابلِ استفاده است. این دوره میگوید چرا — و مهمتر، چطور قبل از اجرا پیشبینیاش کنی: اندازهگیریِ صادقانهٔ زمان، Big-O بهعنوان یک پیشبینی که آزمون میدهد، list و hash و درخت و گراف، مرتبسازی و جستوجو، و یک قاعدهٔ سخت — هیچ ادعای پیچیدگی بدونِ جدولِ اندازهگیری. همه در Google Colab، فقط روی CPU و فقط با کتابخانهٔ استاندارد.
- ۶ ترم
- ۴۹ فصل
- همهٔ فصلها رایگان