فایل آموزشی
آموزش SQL و پایگاه داده از صفر؛ تحلیل داده، مدلسازی و بهینهسازی کوئری (خودآموز آوند)
خودآموز SQL از یک فایل CSV تا تحلیلی که به تصمیم میرسد: SELECT و فیلتر، تجمیع و GROUP BY، تابعهای پنجرهای، JOIN، مدلسازی و طراحی پایگاه داده، و سرعت کوئری با EXPLAIN QUERY PLAN. همه در Google Colab با SQLite، بدون نصب سرور. خودآموز دانلودی کامل و مستقل با جواب تمرینها؛ قالب PDF، EPUB و MOBI، دانلود از حساب کاربری پس از پرداخت.
امتیاز خریدارهای این خودآموز
هنوز امتیازی نیست
میانگین از سومین امتیاز
- ۵ ستاره: ۰ نفر
- ۴ ستاره: ۰ نفر
- ۳ ستاره: ۰ نفر
- ۲ ستاره: ۰ نفر
- ۱ ستاره: ۰ نفر
- قیمت
- ۱۹۹٬۰۰۰ تومان
- قالب
- PDF · EPUB · MOBI
- تعداد صفحه
- ۹۸۴
- حجم
- ۳۲٫۵ مگابایت
- زبان
- فارسی
برای خرید حساب کاربری لازم است و فایل بعد از پرداخت در حساب من میماند.
هر فایل به نام خریدارش آماده میشود: شمارهٔ موبایل و شناسهٔ حساب با خطی ریز در حاشیهٔ صفحهها میآید. برای کاربرانِ زیر ۱۸ سال، بخشی از شماره پوشانده میشود.
این فایل نسخهٔ دانلودی خودآموز آوند — داده: SQL، مدلسازی و تحلیل برای تصمیم است.
دربارهٔ این فایل
نسخهٔ دانلودی خودآموز «آوند — داده: SQL، مدلسازی و تحلیل برای تصمیم» با ۵۱ فصل و ۹۸۴ صفحه.
خودآموزی کامل و مستقل با جوابِ تمرینها: برای خواندن و تمرین به سایت نیازی نیست. فهرست کامل و چند صفحهٔ نمونه را همینجا ببین.
پیشنمایش
این تصویرها چند صفحه از همین فایلاند.
 صفحهٔ ۲
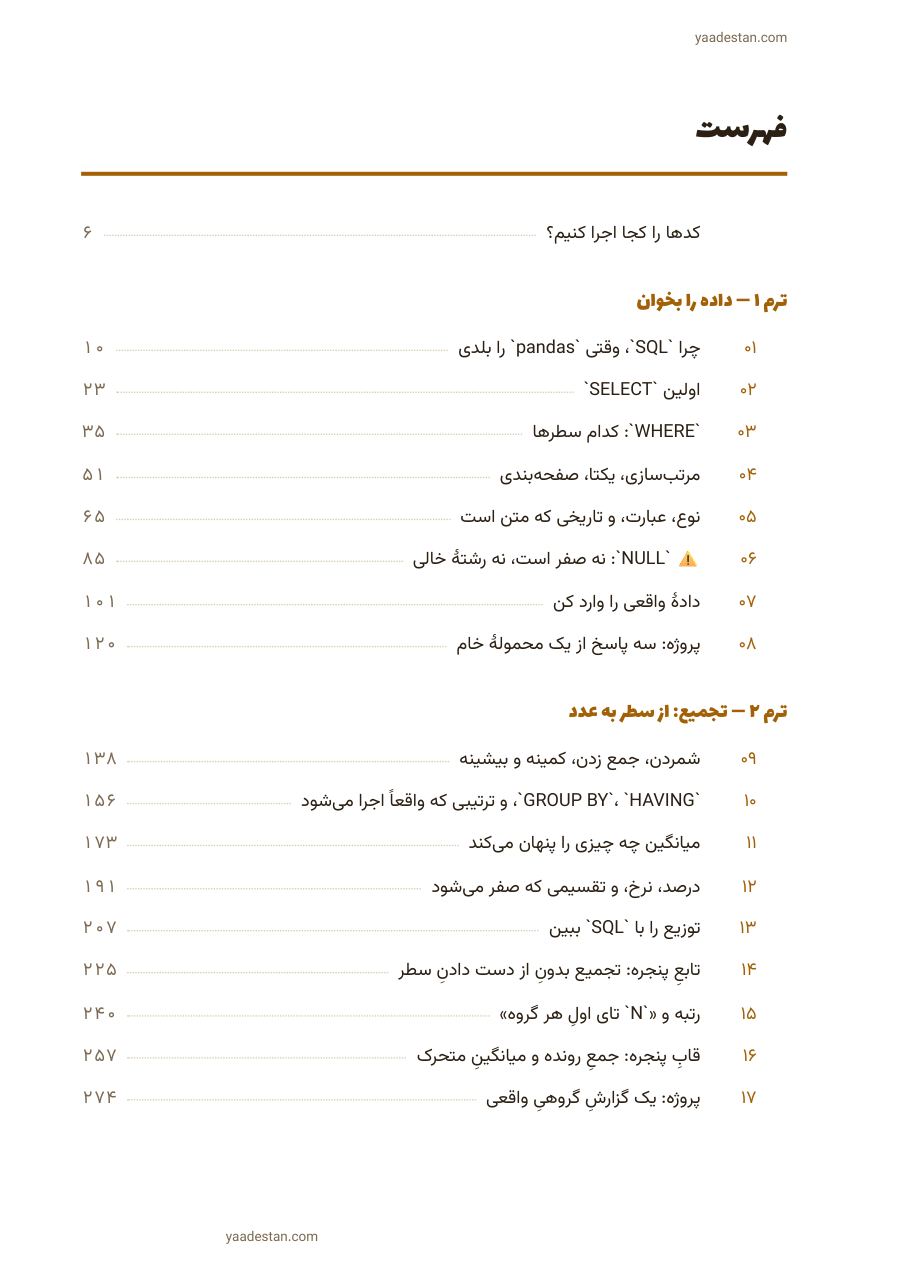 صفحهٔ ۳
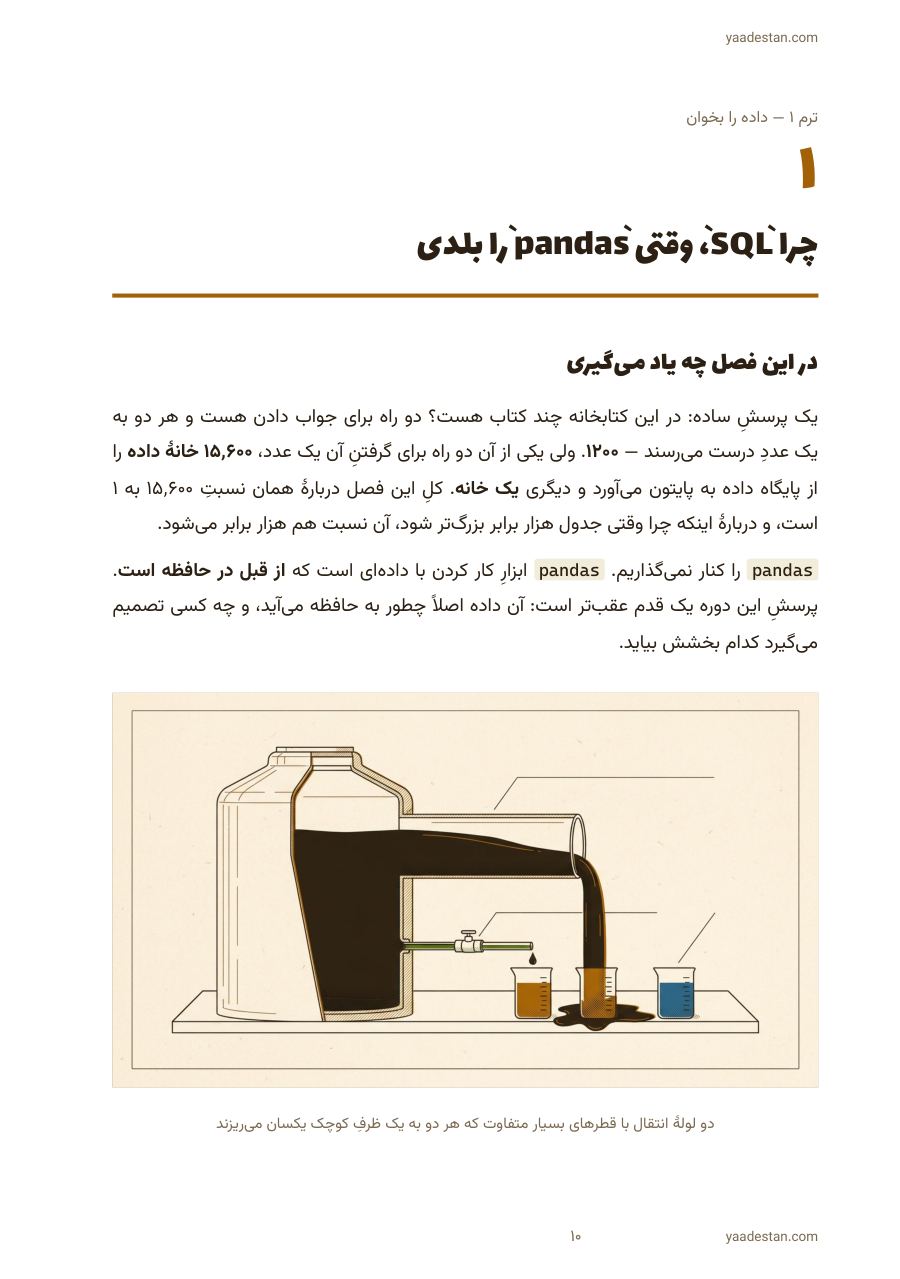 صفحهٔ ۱۰
 صفحهٔ ۱۱
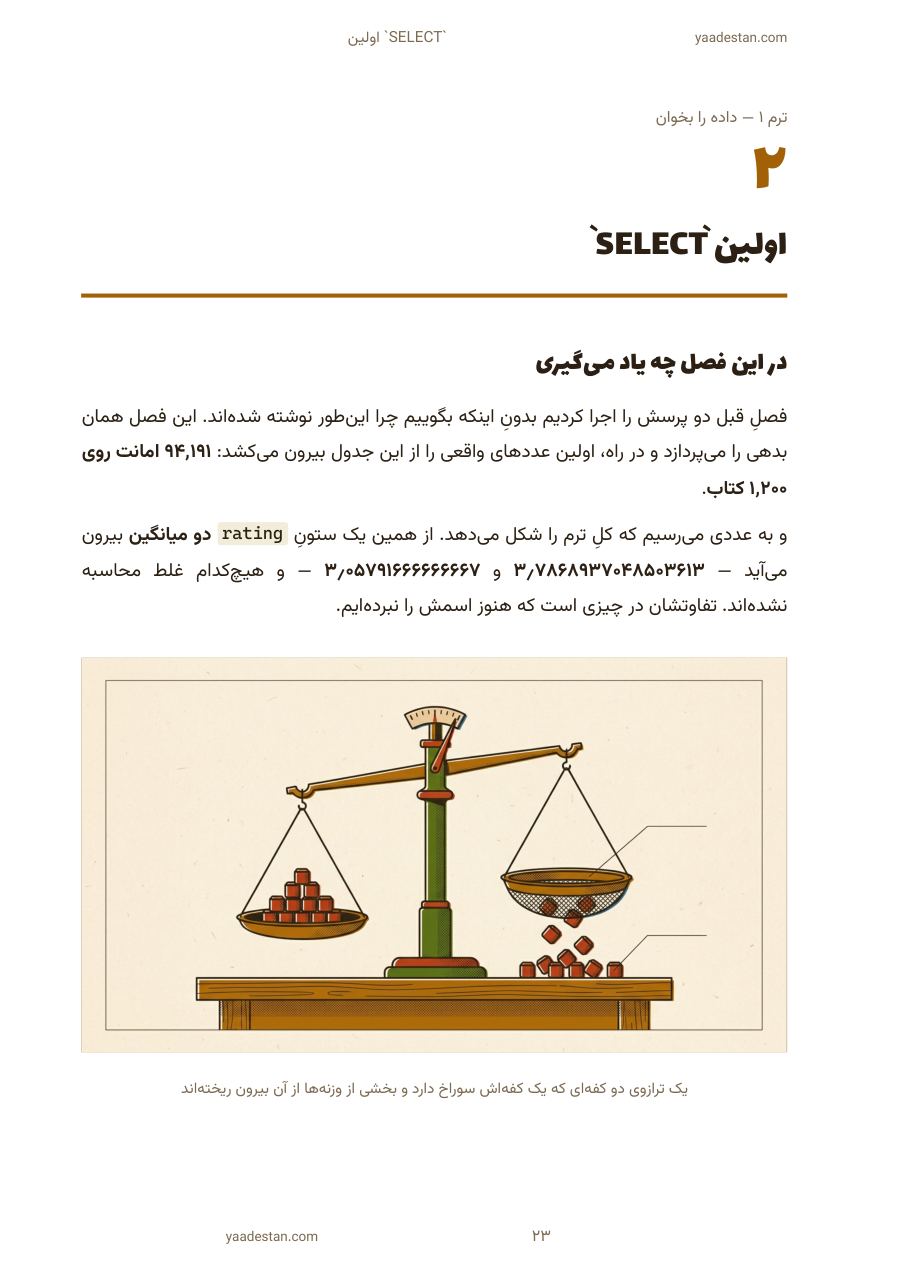 صفحهٔ ۲۳
 صفحهٔ ۲۴
فهرست مطالب
- ترم ۱ — داده را بخوان۱۰
- چرا `SQL`، وقتی `pandas` را بلدی۱۰
- اولین `SELECT`۲۳
- `WHERE`: کدام سطرها۳۵
- مرتبسازی، یکتا، صفحهبندی۵۱
- نوع، عبارت، و تاریخی که متن است۶۵
- ⚠️ `NULL`: نه صفر است، نه رشتهٔ خالی۸۵
- دادهٔ واقعی را وارد کن۱۰۱
- پروژه: سه پاسخ از یک محمولهٔ خام۱۲۰
- ترم ۲ — تجمیع: از سطر به عدد۱۳۸
- شمردن، جمع زدن، کمینه و بیشینه۱۳۸
- `GROUP BY`، `HAVING`، و ترتیبی که واقعاً اجرا میشود۱۵۶
- میانگین چه چیزی را پنهان میکند۱۷۳
- درصد، نرخ، و تقسیمی که صفر میشود۱۹۱
- توزیع را با `SQL` ببین۲۰۷
- تابعِ پنجره: تجمیع بدونِ از دست دادنِ سطر۲۲۵
- رتبه و «`N` تای اولِ هر گروه»۲۴۰
- قابِ پنجره: جمعِ رونده و میانگینِ متحرک۲۵۷
- پروژه: یک گزارشِ گروهیِ واقعی۲۷۴
- ترم ۳ — پیوند: داده در چند جدول۲۹۰
- چرا داده در یک جدول نمیماند، و اولین `JOIN`۲۹۰
- `LEFT JOIN` و سطرهایی که جفت ندارند۳۰۶
- ⚠️ پیوندی که بیصدا سطرها را تکثیر میکند۳۲۲
- پیوندِ جدول با خودش، و `CROSS JOIN`۳۳۹
- `UNION`، `INTERSECT`، `EXCEPT`۳۵۵
- پرسش داخلِ پرسش۳۷۰
- `WITH`: پرسشِ بلند را خوانا کن۳۹۰
- پروژه: یک پاسخ از سه جدول۴۰۶
- ترم ۴ — مدلِ دادهای که نمیپوسد۴۲۴
- از پرسش تا جدول: دانهبندی۴۲۴
- کلید: چه چیزی یک سطر را یکتا میکند۴۴۱
- کلیدِ خارجی و سطرِ یتیم۴۵۹
- هر واقعیت فقط یک جا۴۷۹
- کِی عمداً تکرار میکنیم۵۰۴
- قانونی که پایگاه داده خودش اجرا میکند۵۳۲
- زمان را چطور ذخیره کنیم۵۵۹
- اسکیما عوض میشود۵۸۲
- پروژه: یک `CSV` کثیف را به اسکیمای درست تبدیل کن۶۰۳
- ترم ۵ — کارایی که اندازه میگیری۶۳۰
- اول اندازه بگیر۶۳۰
- `EXPLAIN QUERY PLAN`: ذرهبینِ دوره۶۴۸
- `index`: چه چیزی را سریع میکند، و به چه قیمتی۶۶۵
- ⚠️ `index`ی که کار نمیکند۶۸۷
- نوشتن، تراکنش، و سرعت۷۰۶
- همان پاسخ، پرسشِ سریعتر۷۲۳
- مرزها: کِی `sqlite3` بس نیست۷۴۵
- پروژه: یک پرسشِ کند را با عدد سریع کن۷۶۴
- ترم ۶ — از عدد تا تصمیم۷۹۲
- خواندنِ پرسشی که کسِ دیگری نوشته۷۹۲
- تعریفِ سنجه: قبل از اینکه بشماری۸۱۱
- ⚠️ پرسشی که دروغ میگوید۸۳۱
- مقایسهٔ منصفانه۸۴۸
- آیا این اختلاف واقعی است؟۸۶۷
- تفاوتِ یک عدد و یک تصمیم۸۸۹
- گزارشی که کسی میخواند۹۰۸
- تحلیلی که فردا هم همان است۹۲۷
- پروژهٔ نهایی: از یک پرسشِ واقعی تا یک توصیهٔ قابلِ اجرا۹۵۲
از میز خوانندهها
یادداشتها و پرسشها
ستارهها را فقط کسانی میدهند که آن را خریدهاند و یادداشتشان مهر «خریدار» دارد. پرسیدن دربارهٔ آن برای همه آزاد است و نوشتهٔ اول هر کس پیش از انتشار خوانده میشود.
یادداشتها بعد از بارگذاری صفحه نشان داده میشوند.